前文 哈希表核心原理 中我介绍了哈希表的核心原理和几个关键概念,其中提到了解决哈希冲突的方法主要有两种,分别是拉链法和线性探查法(也常叫做开放寻址法):
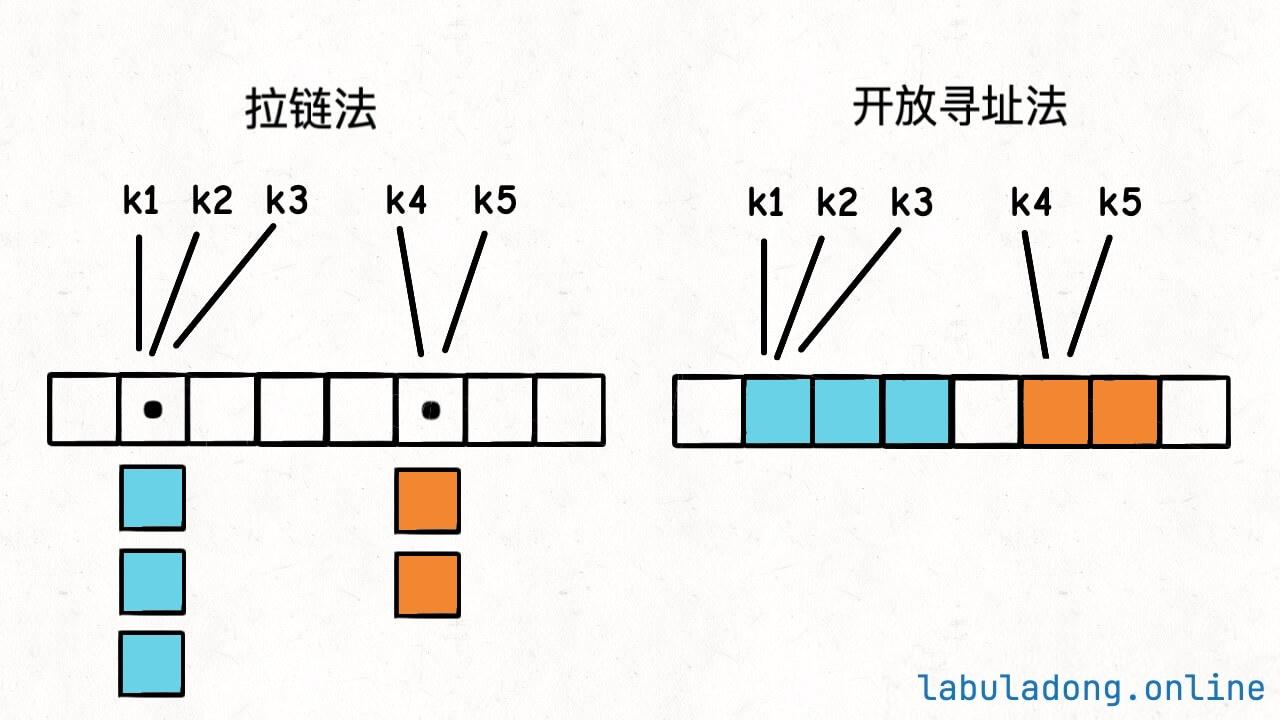
由于线性探查法稍微复杂一些,本文先讲解实现线性探查法的几个难点,下篇文章再给出具体的代码实现。
简化场景
之前介绍的拉链法应该是比较简单的,无非就是 table 中每个元素都是一个链表,出现哈希冲突的话往链表里塞元素就行了。
而线性探查法会更复杂,主要有两个难点,涉及到多种数组操作技巧。在讲清楚这两个难点之前,我们先设定一个简化的场景:
假设我们的哈希表只支持 key 类型为 int,value 类型为 int 的情况,且 table.length 固定为 10,hash 函数的实现是 hash(key) = key % 10。因为这样比较容易模拟出哈希冲突,比如 hash(1) 和 hash(11) 的值都是 1。
线性探查法的大致逻辑如下:
java
// 线性探查法的基本逻辑,伪码实现

class MyLinearProbingHashMap {
    // 数组中每个元素都存储一个键值对
    private KVNode[] table = new KVNode[10];

    private int hash(int key) {
        return key % table.length;
    }

    public void put(int key, int value) {
        int index = hash(key);
        KVNode node = table[index];
        if (node == null) {
            table[index] = new KVNode(key, value);
        } else {
            // 线性探查法的逻辑
            // 向后探查,直到找到 key 或者找到空位
            while (index < table.length && table[index] != null && table[index].key != key) {
                index++;
            }
            table[index] = new KVNode(key, value);
        }
    }

    public int get(int key) {
        int index = hash(key);
        // 向后探查,直到找到 key 或者找到空位
        while (index < table.length && table[index] != null && table[index].key != key) {
            index++;
        }
        if (table[index] == null) {
            return -1;
        }
        return table[index].value;
    }

    public void remove(int key) {
        int index = hash(key);
        // 向后探查,直到找到 key 或者找到空位
        while (index < table.length && table[index] != null && table[index].key != key) {
            index++;
        }
        // 删除 table[index]
        // ...
    }
}
cpp
python
go
javascript
基于这个假设场景,我们来看看线性探查法的两个难点。