视频导读
这个视频会快速过一遍速成目录的内容,建议观看。
有些读者跟我反馈:本站的内容确实够扎实了,如果认真学习,必然可以彻底掌握数据结构和算法,但他们现在的问题是没有那么多时间,何解?
能不能抓大放小,先把必知必会的技巧学会,临阵磨枪快速提升一下,日后有时间再慢慢学习?我觉得这确实是相当一部分读者的需求,所以专门写了这个精简的速成规划。
如果你时间充裕,且对算法有一定的兴趣,那么可以按照 初学者规划 完整学习本站的目录内容。
如果你准备算法的时间不充裕,或者在纠结到底该选 初学者规划 还是 速成规划,那么不用犹豫,直接跟速成规划吧。不要贪多嚼不烂,先把速成规划中的内容掌握好,如果还有时间和兴趣的话,可以再回头学习本站的其他内容,这并不冲突。
速成规划的文章和题目已经整理到这个路线图里,点击图中节点即可展开相关教程和题单,方便你追踪进度和复习:
提示
由于路线图是树形结构,而目录是线性结构,所以路线图中的编排顺序和下面给出的目录有所不同,但内容是完全相同的,你可以选择自己喜欢的形式进行学习。
算法速成路线图
关于题单
经常有读者问公司题单相关的问题,所以这里多说几句。
速成目录包含必知必会的算法套路 + 经典算法题,不局限于具体某家公司的题单。目的是从根本上搞定算法这个硬骨头,让你能够独立解决中等难度的常考算法题,而不是依赖运气和记忆,死记硬背某个题单。
有些读者准备算法,上来就刷公司题单,这是不对的。我的建议是,你先把常见的算法框架学明白,下一步,再考虑刷题单。
不同公司的题单内容和难度不一样,但是算法本身也就那么些框架套路。你把套路都掌握了,一个题单最多也就两三个小时就刷完了,没啥神奇的。
题单只有两个价值:
1、提前了解公司考题的难度及算法类别。比方说你的公司明确说了不会考察动态规划算法,那么你可以跳过本目录的动态规划部分,把时间花在其他算法技巧上。
2、方便复习。学完算法框架之后就可以独立解题了,此时可以独立刷几遍题单,用来检验学习效果,巩固知识点。
速成目录涉及的题目看起来比较多,但大多都是框架题,学完教程后顺手就能全部做完,不用单独去刷。
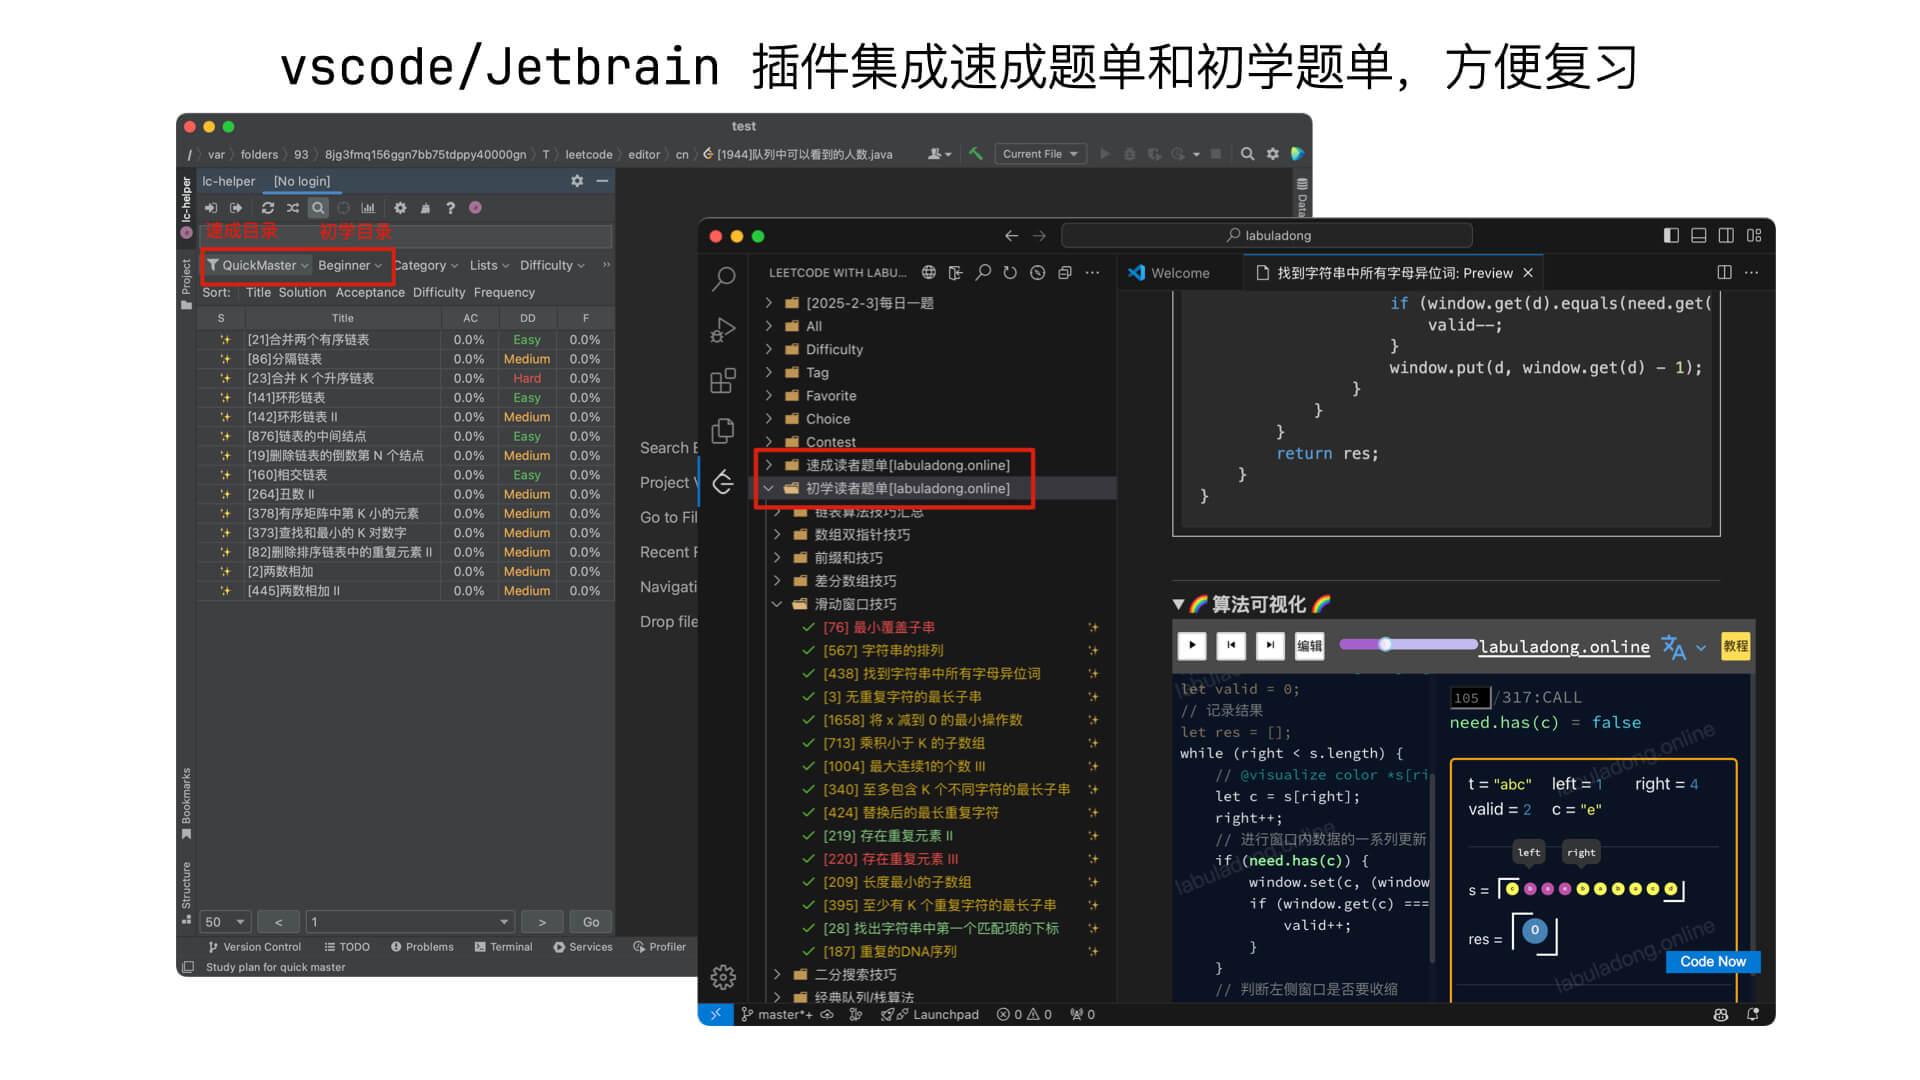
本站插件对速成目录的题目进行了整合,安装 Chrome 插件 后,浏览器打开力扣题目页面将显示本站的思路讲解,vscode 插件 和 Jetbrains 插件 中也集成了这个速成目录的题目列表
速成目录的原理
为什么速成目录能够在短时间内快速提升算法能力?
1、基于模板框架,统一的解法风格。
这个速成目录不是简单的题目列表,而是针对每个算法总结出一套框架模板,习题都使用统一的流程框架进行求解。你学会的是真正的算法解题能力而不是死记硬背,所以你不会局限于具体的题目列表,而是能够收发自如,独立解决没见过的题目。
2、循序渐进,由浅入深,同时包含数据结构和算法。
一个算法技巧 A,可能是算法 B 和算法 C 融合而来的,不给你任何背景铺垫直接讲 A,你就觉得算法高深莫测不可捉摸。但如果把 B 和 C 的基础补齐,你自己都能推导出 A,简直太简单了,有什么了不起的么。
比方很多读者畏惧递归算法,我就多次强调,算法的本质是穷举,递归是基于树结构的一种经典穷举手段,你只要把二叉树结构玩明白,就能玩明白一切递归算法。所以本目录会先从关键数据结构入手,然后再开始刷题。先把基础补齐,刷题就会顺畅高效。
3、科学的学习方法,丰富的辅助工具。例题和习题配合,先讲后练,结合刷题插件、可视化面板,尽一切努力帮助读者降低理解成本,提高学习效率。
再次强调,我非常理解有些读者时间紧迫,但是你不要图省事,不学框架就直接刷题。
只刷题单的问题在于过度依赖运气。运气好遇到原题的话,也许你能默写出解法;一旦没有运气加持,就得靠算法框架解题,你没学过就凉凉了。所谓基础不牢地动山摇,一开始先花时间把基础夯实,算总账反而是最省时间的。
下面就开始吧,速成目录主要分「数据结构」部分和「算法刷题」部分:数据结构部分基本不涉及算法题,相对较简单;刷题部分是重点,一定要认真思考,亲自动手实践。
关于建议用时
下面对每篇文章的建议用时是一个偏大的粗略的估计,假设读者时间并不充裕,每天只花碎片化的 1~2 小时左右的时间学习。
所以这个建议用时仅供参考,具体的学习时间会根据每个人有所差异,如果能够花整块的完整时间学习,速度会快很多。
另外,速成读者不要过度死磕。有些东西不可能完全靠自己想出来的,第一次学习时主要以理解和模仿为主,跟着网站的思路把整个知识体系建立起来;到时候回头再看,很多问题自然就迎刃而解了。
数据结构
数组链表
介绍基本的数组链表概念,比较简单。主要是环形数组这个技巧是重点,可以用 的时间复杂度在数组头部进行插入删除操作。
关键基础,建议用时 1 天
哈希表原理及应用
作为速成教程,我们可以跳过哈希表的两种解决哈希冲突的代码实现,但是哈希表的原理是必须掌握的。
哈希表可以和数组、双链表进行结合,形成更强大的数据结构 LinkedHashMap 和 ArrayHashMap,它们可以给哈希表增加新的特性,你要了解其中的原理,遇到对应的使用场景时,就知道有这么一个工具可以使用。
关键基础,建议用时 1~2 天
二叉树基础及遍历
虽然现在只是基础知识章节,但是二叉树部分必须重视起来,尤其是二叉树的遍历,是入门递归思维关键。后面开始刷题后,所有递归算法的本质上都是二叉树的遍历。
关键基础,建议用时 1~2 天
层序遍历的三种写法模板
第一种,最简单的写法:
void levelOrderTraverse(TreeNode root) {
    if (root == null) {
        return;
    }
    Queue<TreeNode> q = new LinkedList<>();
    q.offer(root);
    while (!q.isEmpty()) {
        TreeNode cur = q.poll();
        // 访问 cur 节点
        System.out.println(cur.val);

        // 把 cur 的左右子节点加入队列
        if (cur.left != null) {
            q.offer(cur.left);
        }
        if (cur.right != null) {
            q.offer(cur.right);
        }
    }
}第二种,可以利用 step 记录层数信息,较常用:
void levelOrderTraverse(TreeNode root) {
    if (root == null) {
        return;
    }
    Queue<TreeNode> q = new LinkedList<>();
    q.offer(root);
    // 记录当前遍历到的层数(根节点视为第 1 层)
    int depth = 1;

    while (!q.isEmpty()) {
        int sz = q.size();
        for (int i = 0; i < sz; i++) {
            TreeNode cur = q.poll();
            // 访问 cur 节点,同时知道它所在的层数
            System.out.println("depth = " + depth + ", val = " + cur.val);

            // 把 cur 的左右子节点加入队列
            if (cur.left != null) {
                q.offer(cur.left);
            }
            if (cur.right != null) {
                q.offer(cur.right);
            }
        }
        depth++;
    }
}第三种,使用自定义 State 类维护每个节点的信息,复杂一些但最灵活,会在图算法或复杂 BFS 算法中见到:
class State {
    TreeNode node;
    int depth;

    State(TreeNode node, int depth) {
        this.node = node;
        this.depth = depth;
    }
}

void levelOrderTraverse(TreeNode root) {
    if (root == null) {
        return;
    }
    Queue<State> q = new LinkedList<>();
    // 根节点的路径权重和是 1
    q.offer(new State(root, 1));

    while (!q.isEmpty()) {
        State cur = q.poll();
        // 访问 cur 节点,同时知道它的路径权重和
        System.out.println("depth = " + cur.depth + ", val = " + cur.node.val);

        // 把 cur 的左右子节点加入队列
        if (cur.node.left != null) {
            q.offer(new State(cur.node.left, cur.depth + 1));
        }
        if (cur.node.right != null) {
            q.offer(new State(cur.node.right, cur.depth + 1));
        }
    }
}二叉堆原理
二叉堆的关键应用是优先级队列。作为速成教程,我们可以跳过优先级队列的实现,但是要理解以下关键点:
1、优先级队列是一种能够自动排序的数据结构,增删元素的复杂度是 ,底层使用二叉堆实现。
2、二叉堆是一种拥有特殊性质的完全二叉树。
3、优先级队列(二叉堆)的核心方法是 swim, sink,用来维护二叉堆的性质。
关键基础,建议用时 0.5 天
图结构
图论算法是一个很大的话题,但是作为数据结构基础章节,我们目前只需要了解图的逻辑表示和具体实现,以及图的遍历算法。
其实也不算复杂,本质上还是前文二叉树结构的延伸,下面这两篇文章给出了图结构的通用实现和遍历算法模板。
关键基础,建议用时 1 天
开始刷题
现在开始刷题,如果你是第一次接触在线刷题平台,可以先看一下 力扣/LeetCode 解题须知 了解力扣刷题的基本规则。
核心框架,建议用时 0.5 天
这篇文章是本站全站内容的纲领,不仅会对上面介绍的数据结构进行总结,还会直接指出所有算法的本质。
其中会出现大量其他文章的链接引用,初次阅读肯定不容易完全理解,但是不必死磕,只要大致了解文中介绍的思维方法即可,在学习后面内容的时候你将会逐渐领会到本文的精髓。
链表
链表相关的题目套路比较固定,主要是双指针技巧。
核心框架,建议用时 1 天
习题,建议用时 1 天
单链表的一个进阶技巧是递归操作单链表,不过这种思路一般用于面试时说一下就行,笔试时就用标准的指针操作即可。
核心框架,建议用时 1 天
数组
数组相关的技巧也主要是双指针,只不过可以分为快慢指针、左右指针几种不同的类型。经典的数组双指针算法有二分搜索、滑动窗口。
有些读者问我为什么不出字符串算法的专题,因为字符串就是字符数组,字符串算法本质上还是数组算法。
核心框架,建议用时 0.5 天
习题,建议用时 1~2 天
核心框架,建议用时 1 天
滑动窗口代码模板(伪码)
// 滑动窗口算法伪码框架
void slidingWindow(String s) {
    // 用合适的数据结构记录窗口中的数据,根据具体场景变通
    // 比如说,我想记录窗口中元素出现的次数,就用 map
    // 如果我想记录窗口中的元素和,就可以只用一个 int
    Object window = ...

    int left = 0, right = 0;
    while (right < s.length()) {
        // c 是将移入窗口的字符
        char c = s[right];
        window.add(c)
        // 增大窗口
        right++;
        // 进行窗口内数据的一系列更新
        ...

        // *** debug 输出的位置 ***
        // 注意在最终的解法代码中不要 print
        // 因为 IO 操作很耗时,可能导致超时
        printf("window: [%d, %d)\n", left, right);
        // ***********************

        // 判断左侧窗口是否要收缩
        while (left < right && window needs shrink) {
            // d 是将移出窗口的字符
            char d = s[left];
            window.remove(d)
            // 缩小窗口
            left++;
            // 进行窗口内数据的一系列更新
            ...
        }
    }
}习题,建议用时 1 天
核心框架,建议用时 1~2 天
二分搜索三种代码模板
int binary_search(int[] nums, int target) {
    int left = 0, right = nums.length - 1;
    while(left <= right) {
        int mid = left + (right - left) / 2;
        if (nums[mid] < target) {
            left = mid + 1;
        } else if (nums[mid] > target) {
            right = mid - 1;
        } else if(nums[mid] == target) {
            // 直接返回
            return mid;
        }
    }
    // 直接返回
    return -1;
}

int left_bound(int[] nums, int target) {
    int left = 0, right = nums.length - 1;
    while (left <= right) {
        int mid = left + (right - left) / 2;
        if (nums[mid] < target) {
            left = mid + 1;
        } else if (nums[mid] > target) {
            right = mid - 1;
        } else if (nums[mid] == target) {
            // 别返回,锁定左侧边界
            right = mid - 1;
        }
    }
    // 判断 target 是否存在于 nums 中
    if (left < 0 || left >= nums.length) {
        return -1;
    }
    // 判断一下 nums[left] 是不是 target
    return nums[left] == target ? left : -1;
}

int right_bound(int[] nums, int target) {
    int left = 0, right = nums.length - 1;
    while (left <= right) {
        int mid = left + (right - left) / 2;
        if (nums[mid] < target) {
            left = mid + 1;
        } else if (nums[mid] > target) {
            right = mid - 1;
        } else if (nums[mid] == target) {
            // 别返回,锁定右侧边界
            left = mid + 1;
        }
    }
    // 由于 while 的结束条件是 right == left - 1,且现在在求右边界
    // 所以用 right 替代 left - 1 更好记
    if (right < 0 || right >= nums.length) {
        return -1;
    }
    return nums[right] == target ? right : -1;
}核心框架,建议用时 1~2 天
前缀和数组代码模板
一维前缀和:
class NumArray {
    // 前缀和数组
    private int[] preSum;

    // 输入一个数组,构造前缀和
    public NumArray(int[] nums) {
        // preSum[0] = 0,便于计算累加和
        preSum = new int[nums.length + 1];
        // 计算 nums 的累加和
        for (int i = 1; i < preSum.length; i++) {
            preSum[i] = preSum[i - 1] + nums[i - 1];
        }
    }

    // 查询闭区间 [left, right] 的累加和
    public int sumRange(int left, int right) {
        return preSum[right + 1] - preSum[left];
    }
}二维前缀和:
class NumMatrix {
    // preSum[i][j] 记录矩阵 [0, 0, i-1, j-1] 的元素和
    private int[][] preSum;

    public NumMatrix(int[][] matrix) {
        int m = matrix.length, n = matrix[0].length;
        if (m == 0 || n == 0) return;
        // 构造前缀和矩阵
        preSum = new int[m + 1][n + 1];
        for (int i = 1; i <= m; i++) {
            for (int j = 1; j <= n; j++) {
                // 计算每个矩阵 [0, 0, i, j] 的元素和
                preSum[i][j] = preSum[i-1][j] + preSum[i][j-1] + matrix[i - 1][j - 1] - preSum[i-1][j-1];
            }
        }
    }

    // 计算子矩阵 [x1, y1, x2, y2] 的元素和
    public int sumRegion(int x1, int y1, int x2, int y2) {
        // 目标矩阵之和由四个相邻矩阵运算获得
        return preSum[x2+1][y2+1] - preSum[x1][y2+1] - preSum[x2+1][y1] + preSum[x1][y1];
    }
}差分数组代码模板
// 差分数组工具类
class Difference {
    // 差分数组
    private int[] diff;

    // 输入一个初始数组,区间操作将在这个数组上进行
    public Difference(int[] nums) {
        assert nums.length > 0;
        diff = new int[nums.length];
        // 根据初始数组构造差分数组
        diff[0] = nums[0];
        for (int i = 1; i < nums.length; i++) {
            diff[i] = nums[i] - nums[i - 1];
        }
    }

    // 给闭区间 [i, j] 增加 val(可以是负数)
    public void increment(int i, int j, int val) {
        diff[i] += val;
        if (j + 1 < diff.length) {
            diff[j + 1] -= val;
        }
    }

    // 返回结果数组
    public int[] result() {
        int[] res = new int[diff.length];
        // 根据差分数组构造结果数组
        res[0] = diff[0];
        for (int i = 1; i < diff.length; i++) {
            res[i] = res[i - 1] + diff[i];
        }
        return res;
    }
}队列/栈
队列和栈本身是比较简单的数据结构,但是它们在算法题中的运用需要专门练习。
核心框架,建议用时 0.5 天
习题,建议用时 1~2 天
单调栈和单调队列是基于栈和队列的两种变体,它们能够解决一些特殊的问题,需要掌握。
核心框架,建议用时 1~2 天
习题,建议用时 1~2 天
二叉树 & 递归思想
所有递归算法的本质上都是二叉树的遍历,而且二叉树算法经常出现在面试/笔试中,所以二叉树章节我多放几篇文章,希望大家认真学习理解,亲自动手实践。
核心框架,建议用时 1 天
这篇核心纲领是一个总纲,主要有两部分内容:第一部分是如何在实际的算法题中理解二叉树的前中后序位置;第二部分是从二叉树的角度介绍回溯/动态规划等算法。
现在你已经了解了二叉树遍历算法,所以请认真学习第一部分。第二部分讲到的高级算法目前还没有学习,你只要有个印象就行了,等到后面学习了回溯/动态规划再回来看就会有更深的理解。
习题,建议用时 1 天
习题,建议用时 2 天
我非常强调二叉树相关算法题的重要性,因为算法的本质是穷举,树结构是所有暴力穷举算法的核心抽象。你把二叉树玩明白了,后面的高级算法都能很容易理解。
本站的 二叉树算法习题集 专门用一整个章节来练习二叉树算法,依照 二叉树算法(纲领篇) 的分类,把二叉树的习题分为三大部分:
1、递归,用「遍历」的思维模式解题。
2、递归,用「分解问题」的思维模式解题。
3、非递归,用「层序遍历」的思维模式解题。
其中「遍历」的思维模式就是后面讲的 DFS 算法、回溯算法的原型,「分解问题」的思维模式就是后面讲的动态规划、分治算法的原型,「层序遍历」就是后面讲的 BFS 算法的原型。
所以这里必须要对这几种二叉树算法进行练习。二叉树算法习题集 总量比较多,下面仅为速成读者列出难度适中且考察频率高的习题:
如果你有时间和兴趣,可以自行查看其他习题章节进行练习。
二叉搜索树
二叉搜索树是特殊的二叉树,你就记住它的特点是「左小右大」,好好利用这个特点,来优化二叉树的遍历过程。
核心框架,建议用时 1~2 天
核心框架,建议用时 1 天
数据结构设计
LRU 是经典的数据结构设计问题,必须掌握;LFU 难度更大一些,可以作为选学。
习题,建议用时 1 天
习题,建议用时 1 天
实现计算器是一个经典的数据结构设计题目,没时间的话可以把最后给出的计算器代码保存下来,如果笔试遇到字符串计算相关的题目,可以直接复制粘贴拿去用。
通用计算器代码实现
class Solution {
    public int calculate(String s) {
        // key 是左括号的索引,value 是对应的右括号的索引
        Map<Integer, Integer> rightIndex = new HashMap<>();
        // 利用栈结构来找到对应的括号
        Stack<Integer> stack = new Stack<>();
        for (int i = 0; i < s.length(); i++) {
            if (s.charAt(i) == '(') {
                stack.push(i);
            } else if (s.charAt(i) == ')') {
                rightIndex.put(stack.pop(), i);
            }
        }
        return _calculate(s, 0, s.length() - 1, rightIndex);
    }

    // 定义:返回 s[start..end] 内的表达式的计算结果
    private int _calculate(String s, int start, int end, Map<Integer, Integer> rightIndex) {
        // 需要把字符串转成双端队列方便操作
        Stack<Integer> stk = new Stack<>();
        // 记录算式中的数字
        int num = 0;
        // 记录 num 前的符号,初始化为 +
        char sign = '+';
        for (int i = start; i <= end; i++) {
            char c = s.charAt(i);
            if (Character.isDigit(c)) {
                num = 10 * num + (c - '0');
            }
            if (c == '(') {
                // 递归计算括号内的表达式
                num = _calculate(s, i + 1, rightIndex.get(i) - 1, rightIndex);
                i = rightIndex.get(i);
            }
            if (c == '+' || c == '-' || c == '*' || c == '/' || i == end) {
                int pre;
                switch (sign) {
                    case '+':
                        stk.push(num);
                        break;
                    case '-':
                        stk.push(-num);
                        break;
                    // 只要拿出前一个数字做对应运算即可
                    case '*':
                        pre = stk.pop();
                        stk.push(pre * num);
                        break;
                    case '/':
                        pre = stk.pop();
                        stk.push(pre / num);
                        break;
                }
                // 更新符号为当前符号,数字清零
                sign = c;
                num = 0;
            }
        }
        // 将栈中所有结果求和就是答案
        int res = 0;
        while (!stk.isEmpty()) {
            res += stk.pop();
        }
        return res;
    }
}习题,建议用时 1 天
图算法
环检测、拓扑排序、二分图判定是经典的图算法,本质上就是对图的遍历,并不难掌握。
核心框架,建议用时 1~2 天
Union Find 算法是比较实用的图算法,你需要了解它的原理和 API。
建议把最后给出的 UF 类提前保存下来,若笔试允许使用 IDE 则可以直接复用。
核心框架,建议用时 1 天
Union Find 代码模板
这里直接给出效率最高的路径压缩代码实现:
class UF {
    // 连通分量个数
    private int count;
    // 存储每个节点的父节点
    private int[] parent;

    // n 为图中节点的个数
    public UF(int n) {
        this.count = n;
        parent = new int[n];
        for (int i = 0; i < n; i++) {
            parent[i] = i;
        }
    }

    // 将节点 p 和节点 q 连通
    public void union(int p, int q) {
        int rootP = find(p);
        int rootQ = find(q);

        if (rootP == rootQ)
            return;

        parent[rootQ] = rootP;
        // 两个连通分量合并成一个连通分量
        count--;
    }

    // 判断节点 p 和节点 q 是否连通
    public boolean connected(int p, int q) {
        int rootP = find(p);
        int rootQ = find(q);
        return rootP == rootQ;
    }

    public int find(int x) {
        if (parent[x] != x) {
            parent[x] = find(parent[x]);
        }
        return parent[x];
    }

    // 返回图中的连通分量个数
    public int count() {
        return count;
    }
}最小生成树问题也是比较实用的图论算法,你需要了解它的定义及使用场景。
Kruskal 和 Prim 是两种经典的最小生成树算法。其中 Kruskal 算法的本质是 Union Find 算法 + 排序,相对简单,所以速成读者了解 Kruskal 算法即可。
核心框架,建议用时 1 天
Dijkstra 最短路径算法属于经典图论算法,需要掌握。它的本质就经过改良的二叉树 BFS 算法,你可以把模板保存下来,以便笔试时快速运用。
核心框架,建议用时 1 天
Dijkstra 算法模板(伪码)
class State {
    // 当前节点 ID
    int node;
    // 从起点 s 到当前 node 节点的最小路径权重和
    int distFromStart;

    public State(int node, int distFromStart) {
        this.node = node;
        this.distFromStart = distFromStart;
    }
}

// 输入不包含负权重边的加权图 graph 和起点 src
// 返回从起点 src 到其他节点的最小路径权重和
int[] dijkstra(Graph graph, int src) {
    // 记录从起点 src 到其他节点的最小路径权重和
    // distTo[i] 表示从起点 src 到节点 i 的最小路径权重和
    int[] distTo = new int[graph.size()];
    // 都初始化为正无穷,表示未计算
    Arrays.fill(distTo, Integer.MAX_VALUE);

    // 优先级队列,distFromStart 较小的节点排在前面
    Queue<State> pq = new PriorityQueue<>((a, b) -> {
        return a.distFromStart - b.distFromStart;
    });

    // 从起点 src 开始进行 BFS
    pq.offer(new State(src, 0));
    distTo[src] = 0;

    while (!pq.isEmpty()) {
        State state = pq.poll();
        int curNode = state.node;
        int curDistFromStart = state.distFromStart;

        if (distTo[curNode] < curDistFromStart) {
            // 在 Dijkstra 算法中,队列中可能存在重复的节点 state
            // 所以要在元素出队时进行判断,去除较差的重复节点
            continue;
        }

        for (Edge e : graph.neighbors(curNode)) {
            int nextNode = e.to;
            int nextDistFromStart = curDistFromStart + e.weight;

            if (distTo[nextNode] <= nextDistFromStart) {
                continue;
            }

            // 将 nextNode 节点加入优先级队列
            pq.offer(new State(nextNode, nextDistFromStart));
            // 记录 nextNode 节点到起点的最小路径权重和
            distTo[nextNode] = nextDistFromStart;
        }
    }

    return distTo;
}DFS/回溯算法
回溯算法是一种纯粹的暴力穷举算法,必须掌握。
因为笔试时是按照通过的测试用例数量来算分的,如果有些题目你实在写不出最优解,写一个回溯算法暴力穷举一下,虽然过不了所有测试用例,但是能过一部分,也能捞到一点分数。
下面列举的文章中的例题都是经典的回溯算法题目,必知必会,一定要透彻地掌握。
核心框架,建议用时 1~2 天
核心框架,建议用时 1~2 天
习题,建议用时 2 天
大部分回溯算法的本质就是排列组合,你把 回溯算法秒杀所有排列/组合/子集问题 想明白,很多回溯题目都可以直接秒。
本站的回溯算法习题章节如下:
不过习题章节的题目比较多,如果你有时间可以都看一看,时间紧的话我帮你精选几道。建议安装 Chrome 插件,在题目页面可以查看本站的思路和解法代码:
BFS 算法
BFS 也是一种暴力穷举算法,必须掌握。它的本质就是二叉树的层序遍历,适合解决最短路径问题。
核心框架,建议用时 1 天
习题,建议用时 2 天
本站的 BFS 习题章节如下:
不过这两章习题比较多,如果你有时间可以都刷完,时间紧的话我帮你精选几道做一做。建议安装 Chrome 插件,在题目页面可以查看本站的思路和解法代码:
动态规划
动态规划本质上也是暴力穷举,只不过有些问题的穷举过程中存在重叠子问题,所以可以通过备忘录进行优化,对于这类算法,我们通常称为动态规划算法。
动态规划的暴力穷举解法一般是递归形式,优化方法非常固定,要么就是添加备忘录,要么就是改写成迭代形式。
动态规划的难点在于那个暴力解(状态转移方程)怎么写,请你阅读下面的文章,尤其注意得到状态转移方程的思维过程。
核心框架,建议用时 1~2 天
核心框架,建议用时 1~2 天
习题,建议用时 1~2 天
习题,建议用时 1~2 天
贪心算法
一般的算法问题,需要暴力穷举所有解,从中找到最优解。
而有些算法问题,如果你充分利用信息,不需要用暴力穷举所有解,就能找到最优解,这就叫贪心选择性质,这种算法叫贪心算法。
所以贪心算法没有固定的套路,它的关键在于细心观察,看看是否能够充分利用信息,提前排除一些不可能是最优解的情况。
核心框架,建议用时 1 天
分治算法
有一部分算法问题,分而治之会有更高的效率,下面这篇分治算法教程所讲的例题是前面讲过的一道链表题目。
核心框架,建议用时 1 天
数学
一般笔试中数学相关算法比较少,不过一些经典的技巧还是有必要掌握。
习题,建议用时 1~2 天
其他经典面试题
这里列出一些经典算法题,它们本质上都是上面介绍的算法的运用。掌握了上面的所有算法后,一般难度的面试题你应该都能够解决了。
习题,建议用时 1~2 天
习题,建议用时 1~2 天
nSum 万能函数
// 注意:调用这个函数之前一定要先给 nums 排序
// n 填写想求的是几数之和,start 从哪个索引开始计算(一般填 0),target 填想凑出的目标和
List<List<Integer>> nSumTarget(int[] nums, int n, int start, long target) {
    int sz = nums.length;
    List<List<Integer>> res = new ArrayList<>();
    // 至少是 2Sum,且数组大小不应该小于 n
    if (n < 2 || sz < n) return res;
    // 2Sum 是 base case
    if (n == 2) {
        // 双指针那一套操作
        int lo = start, hi = sz - 1;
        while (lo < hi) {
            int sum = nums[lo] + nums[hi];
            int left = nums[lo], right = nums[hi];
            if (sum < target) {
                while (lo < hi && nums[lo] == left) lo++;
            } else if (sum > target) {
                while (lo < hi && nums[hi] == right) hi--;
            } else {
                res.add(new ArrayList<>(Arrays.asList(left, right)));
                while (lo < hi && nums[lo] == left) lo++;
                while (lo < hi && nums[hi] == right) hi--;
            }
        }
    } else {
        // n > 2 时,递归计算 (n-1)Sum 的结果
        for (int i = start; i < sz; i++) {
            List<List<Integer>> sub = nSumTarget(nums, n - 1, i + 1, target - nums[i]);
            for (List<Integer> arr : sub) {
                // (n-1)Sum 加上 nums[i] 就是 nSum
                arr.add(nums[i]);
                res.add(arr);
            }
            while (i < sz - 1 && nums[i] == nums[i + 1]) i++;
        }
    }
    return res;
}排序算法
在笔试和面试中,一般不会出现排序算法的题目让你写代码;但是在面试中可能会问到经典排序算法的原理、时间复杂度和适用场景,所以你需要对十大经典排序算法有所了解。
排序算法串讲,建议用时 1 天
建议观看 十大排序算法导读 中的视频,了解十大排序算法的核心原理、复杂度分析和适用场景。