一致性哈希是分布式系统中的经典算法,面试中经常被问到。本文通过一个分布式缓存的例子,带你理解为什么需要一致性哈希,以及如何实现它。
假设你有 3 台 Redis 服务器组成缓存集群,需要把数据分散存储。现在面临三个核心问题:
1、数据路由:给定一个 key,应该去哪台服务器存取?
2、节点故障:某台服务器宕机了,如何让其他服务器接管?
3、集群扩容:新增服务器时,如何让数据迁移量最小?
下面我们来看几种解决方案。
方案一:取模法
最简单的思路:对 key 计算哈希值,然后对服务器数量取模。
hash(key) % N比如有 3 台服务器,查询 "user:1001" 这个 key,计算 hash("user:1001") % 3 = 1,那就去 1 号服务器存取这个数据。
 服务器0       服务器1       服务器2
   |             |             |
hash%3=0 hash%3=1 hash%3=2取模法简单直接,但有个致命问题:当服务器数量变化时,几乎所有 key 都需要重新映射。
比如从 3 台扩容到 4 台,原本 hash % 3 = 1 的 key,现在 hash % 4 可能等于 0、1、2、3 中的任意一个。算一下,大约 75% 的 key 要迁移到其他服务器。
如果是从 100 台扩容到 101 台呢?99% 的数据都要迁移,这对线上系统是灾难性的。
方案二:固定哈希区间法
既然取模法的问题是「节点数量变化导致大量迁移」,那我们换个思路:把哈希值映射到一个固定区间,让每台服务器负责其中一段。
比如抽象出 [0, 65535] 的哈希区间,4 台服务器平分:
 0               16,384            32,768           49,152             65,536
 |------- N1 ------|------- N2 ------|------- N3 ------|------- N4 ------|
对 key 计算哈希值映射到这个区间,就能找到负责它的服务器。
如果 N3 宕机,它的区间交给相邻的 N4:
0               16,384            32,768                              65,536
|------- N1 ------|------- N2 ------|---------------- N4 ---------------|
如果新服务器 N5 加入,把最长的区间分一半给它:
0               16,384            32,768           49,152             65,536
|------- N1 ------|------- N2 ------|------- N5 ------|------- N4 ------|这个方案解决了取模法的问题:节点变化时只需要迁移一小部分数据。但它有另一个隐患——数据倾斜。
比如 N2 也宕机了,它的区间交给 N5:
0               16,384                               49,152             65,536
|------- N1 ------|---------------- N5 ---------------|------- N4 ------|
此时 N5 的负载是 N1 和 N4 的两倍。随着更多节点下线,倾斜会越来越严重:
0               16,384                                                65,536
|------- N1 ------|-------------------------- N5 -----------------------|
按照这个算法,节点下线后很容易产生数据倾斜,某些服务器压力过大。
方案三:一致性哈希
一致性哈希的核心思想是:把哈希空间组织成一个环,让数据和节点都映射到这个环上。
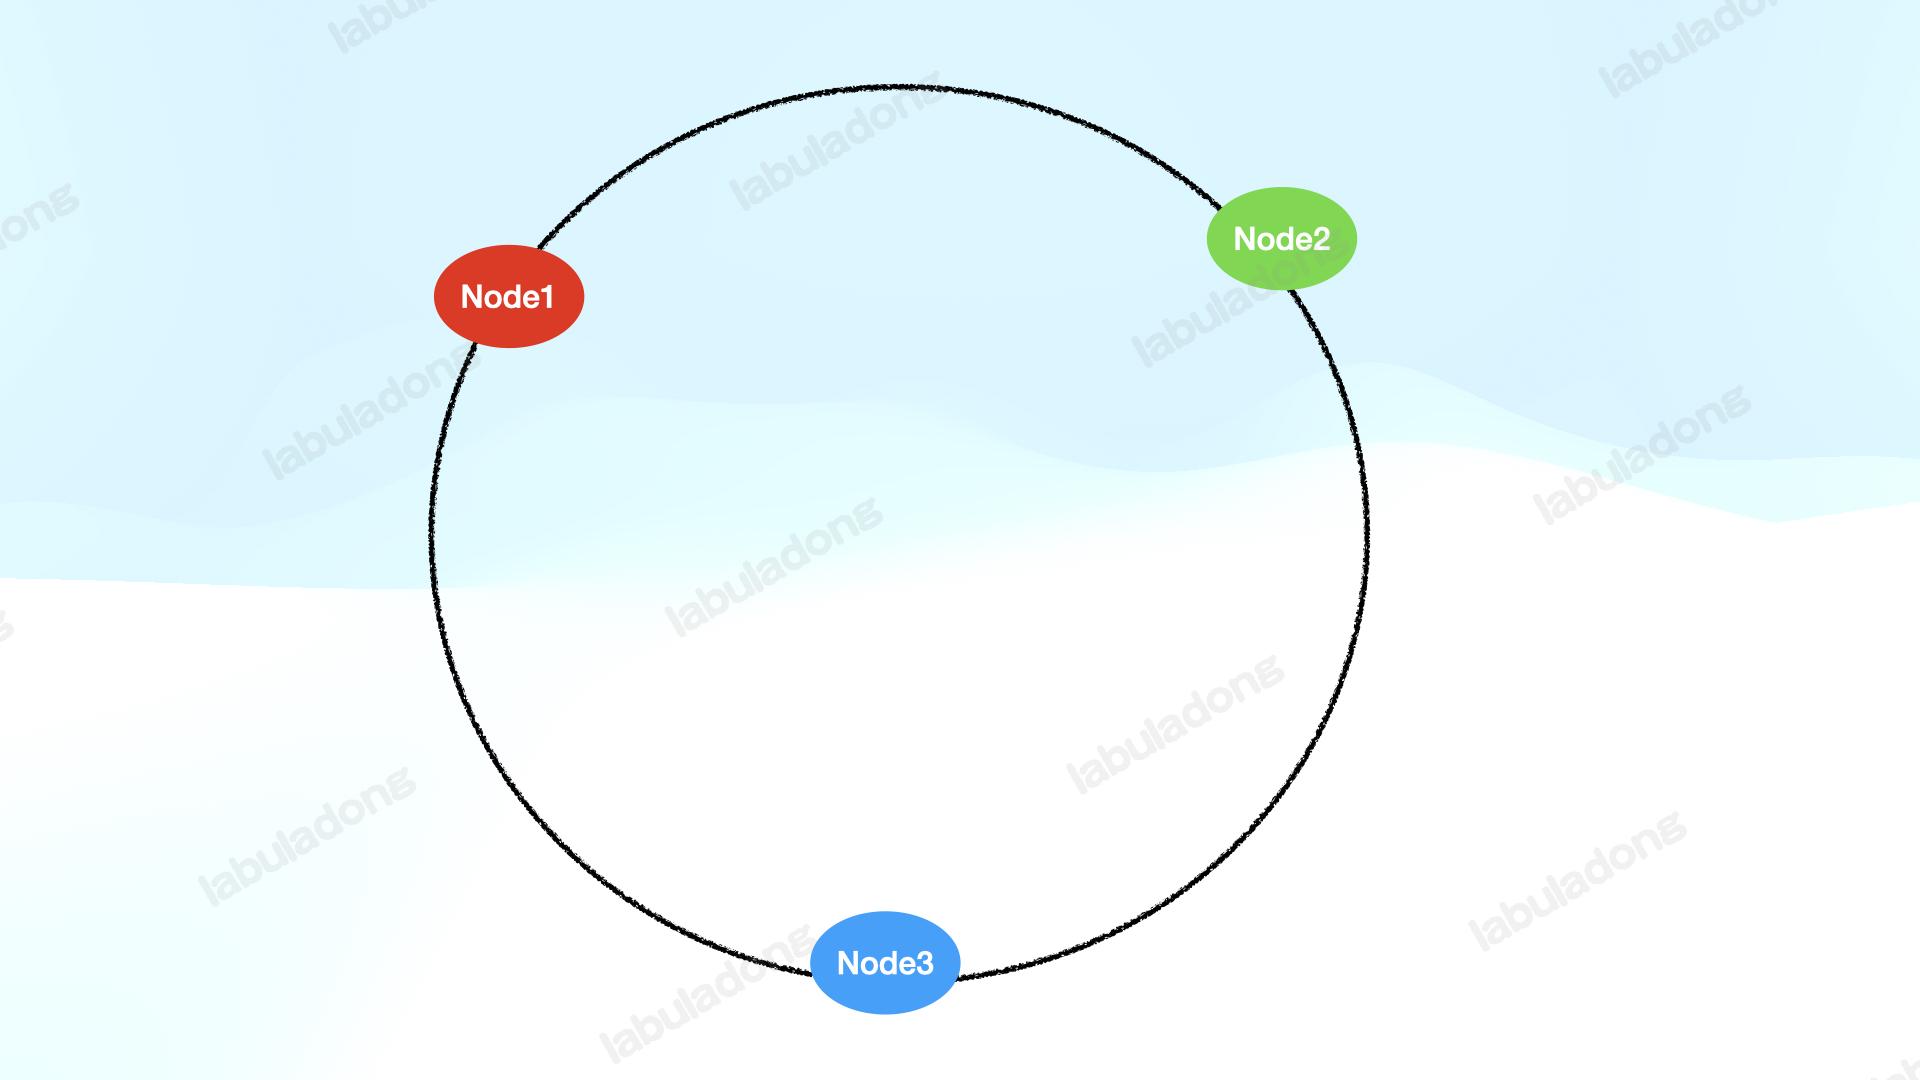
数据的路由规则是:从数据在环上的位置出发,顺时针找到的第一个节点就负责这个数据。
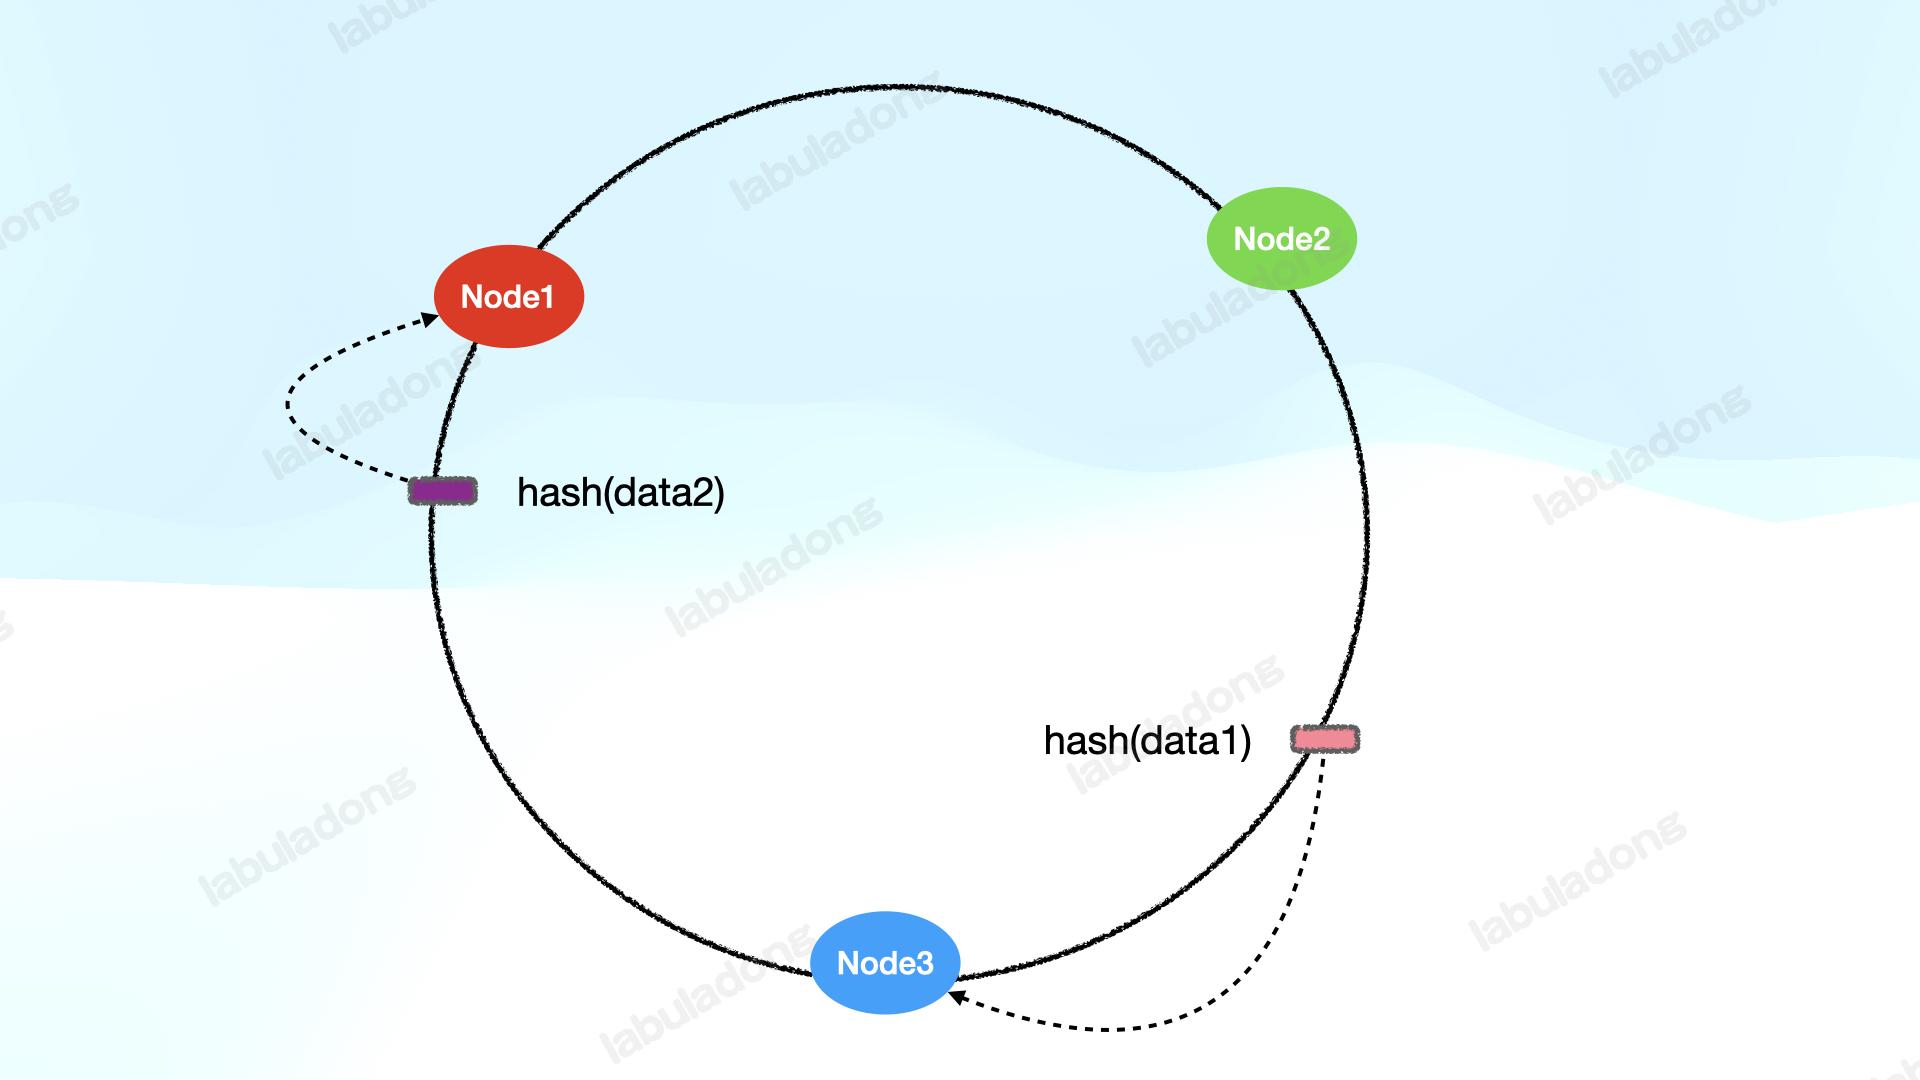
这样,当某个节点下线时,只有它负责的数据需要迁移到下一个节点,其他数据不受影响。
但这个基础版本仍然有数据倾斜的问题:
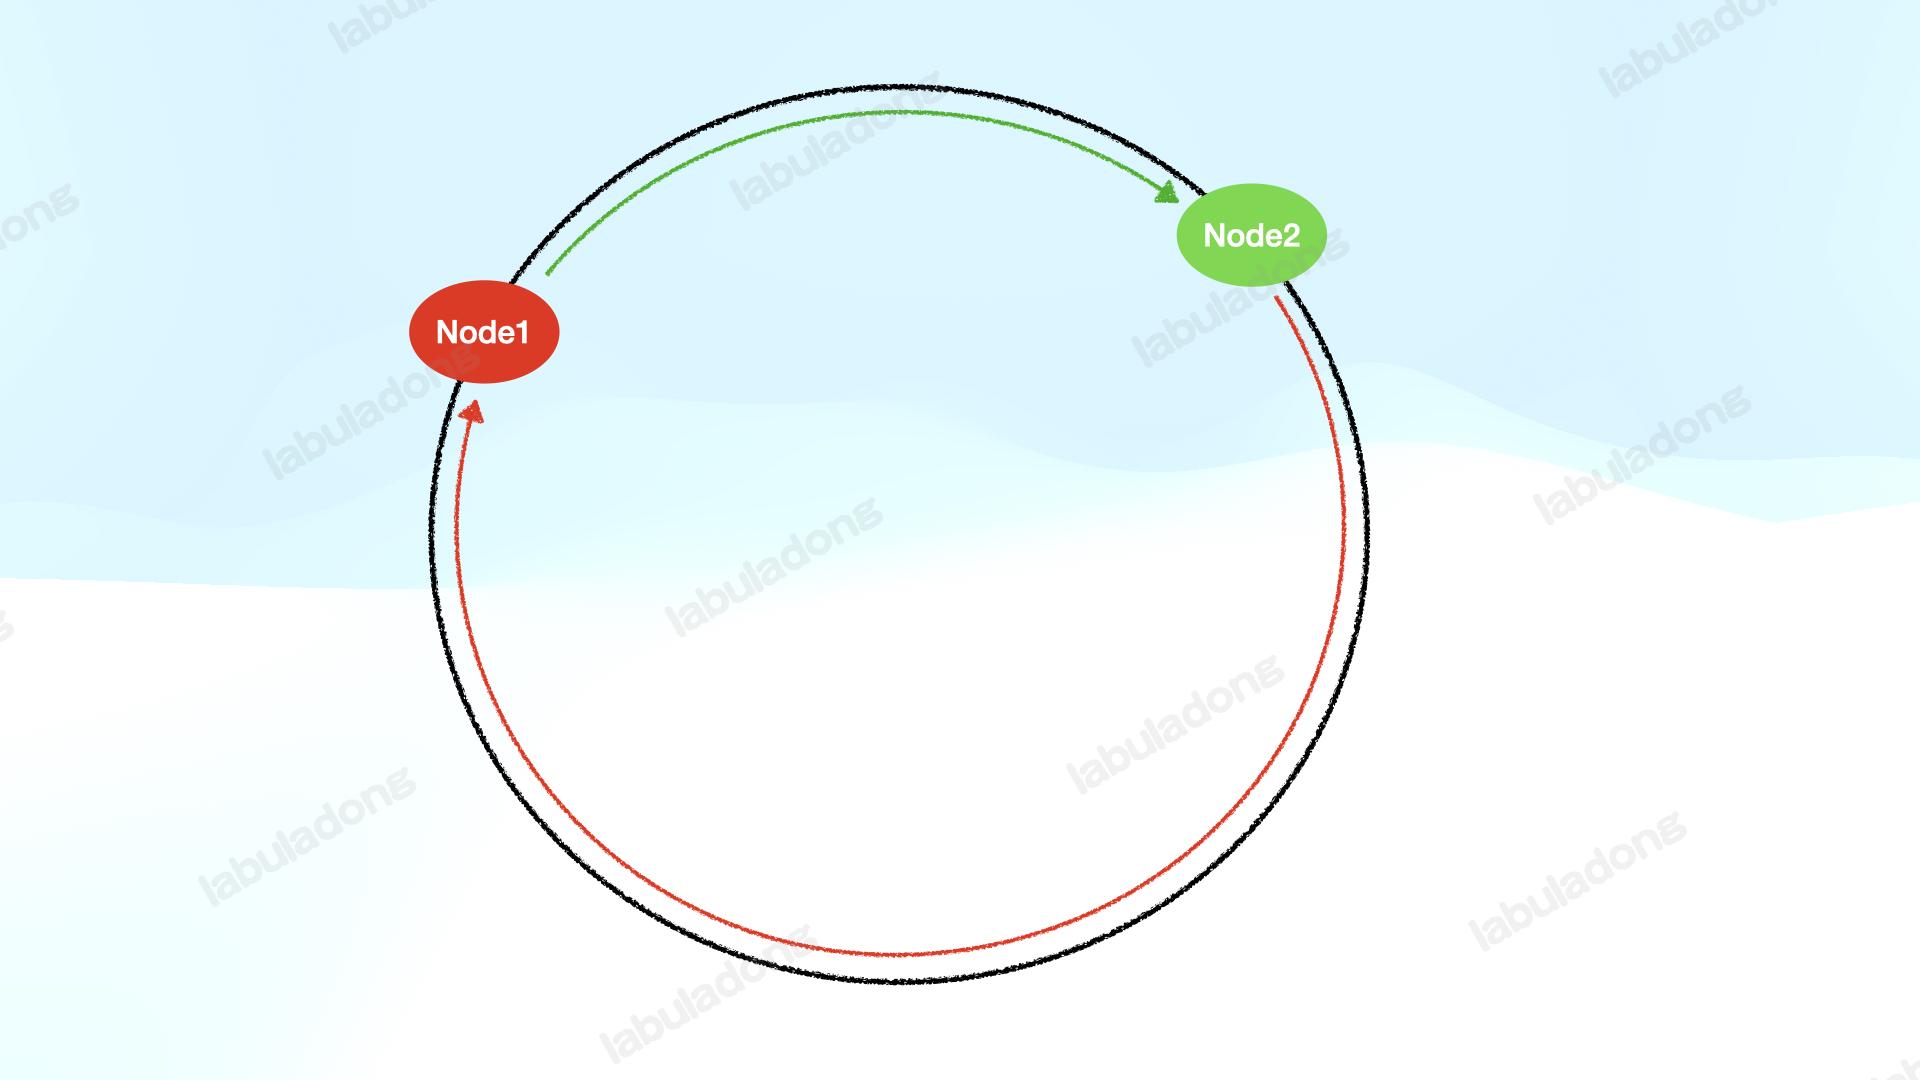
解决方案是引入「虚拟节点」:每台物理服务器不再只映射一个点,而是映射多个虚拟节点到哈希环上。
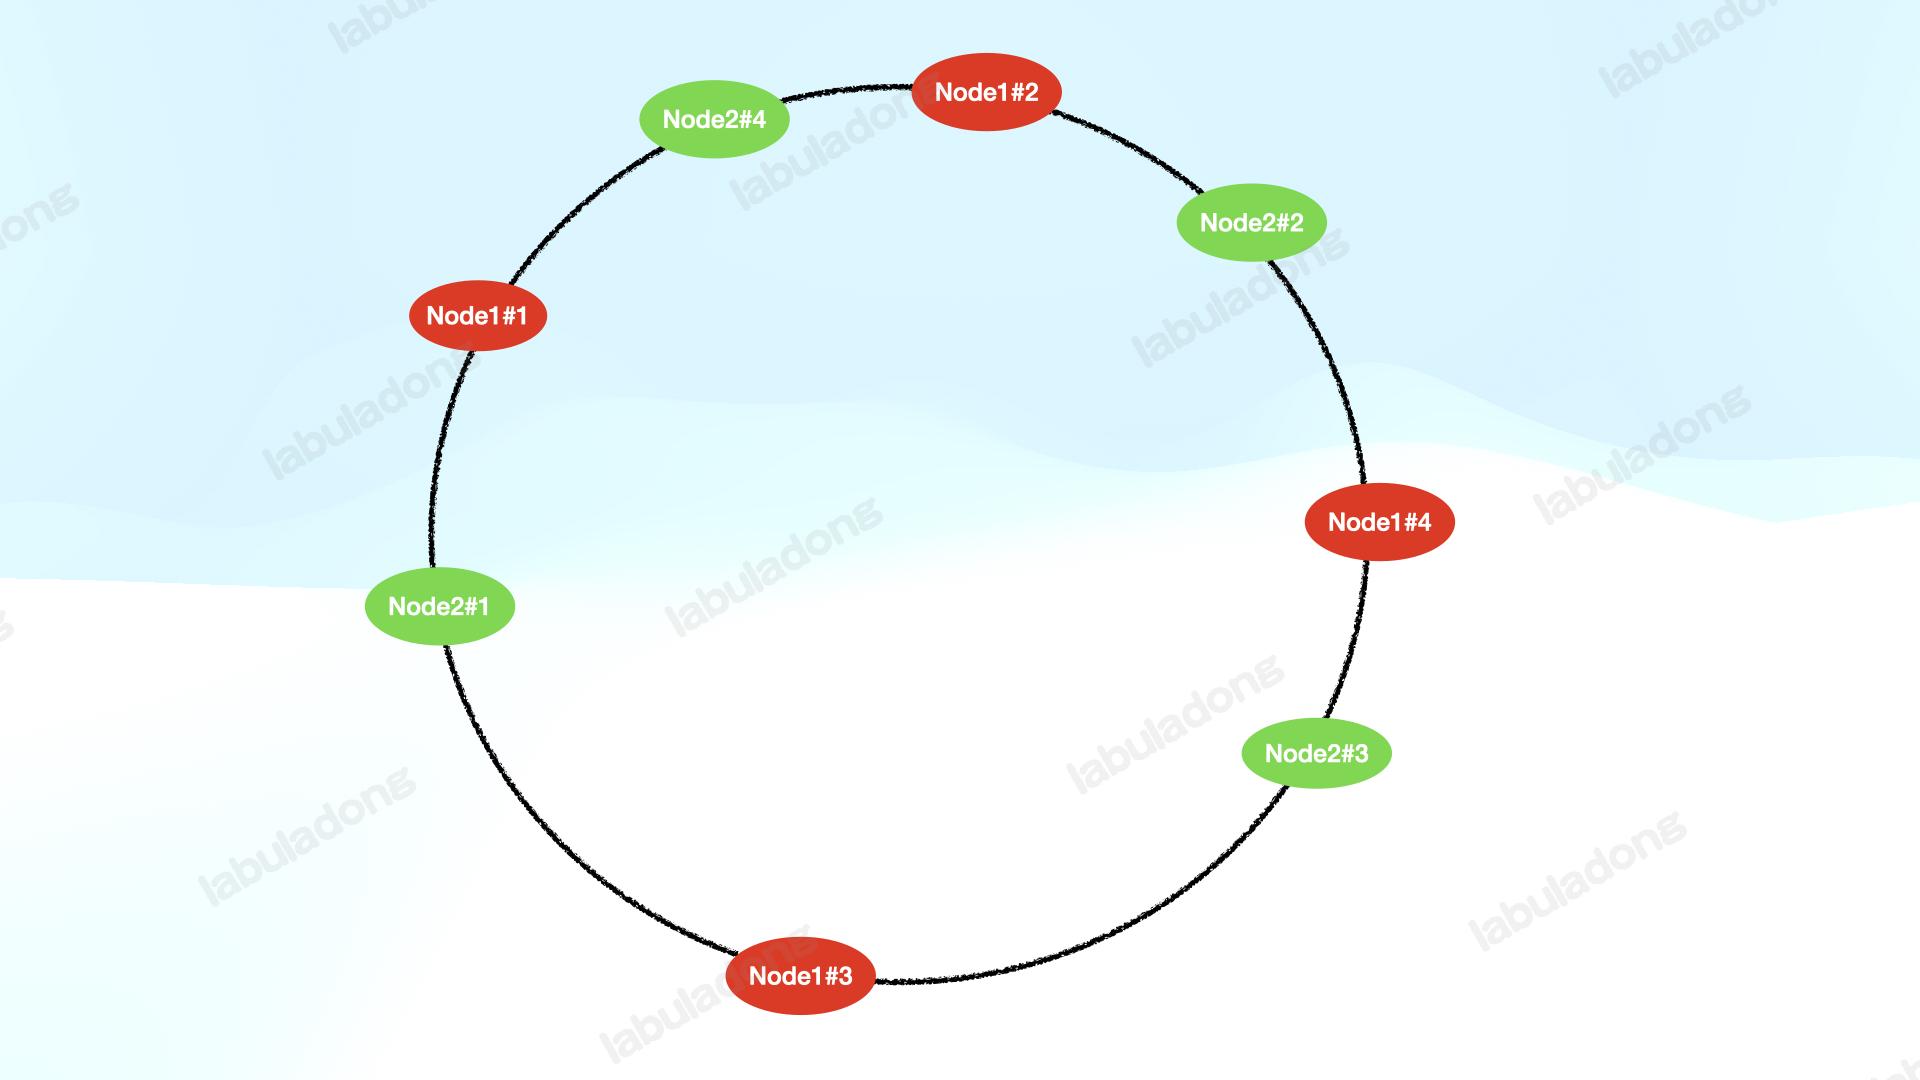
比如每台服务器映射 100 个虚拟节点,3 台服务器就是 300 个虚拟节点分布在环上。由于哈希函数的随机性,这 300 个点会比较均匀地散落在环上,数据自然也就均匀分配了。
当某台服务器下线时,它的 100 个虚拟节点从环上摘除。关键在于:这 100 个虚拟节点的「下一位」不太可能都是同一台服务器的虚拟节点,所以负载会分散到多台服务器上,而不是全压到一台。这就解决了数据倾斜的问题。
代码实现
下面给出代码实现。以 Java 为例,哈希环用 TreeMap 实现,它的 ceilingKey 方法可以找到大于等于给定值的最小 key,正好对应「顺时针找到第一个节点」的操作:
import java.util.*;
import java.security.*;

public class ConsistentHash {
    // 哈希环: 虚拟节点哈希值 -> 物理节点名称
    private final TreeMap<Long, String> ring = new TreeMap<>();
    // 每个物理节点对应的虚拟节点数量
    private final int virtualNodes;

    public ConsistentHash(int virtualNodes) {
        this.virtualNodes = virtualNodes;
    }

    public void addNode(String node) {
        // 一个物理节点映射成 virtualNodes 个虚拟节点,分散到环上
        for (int i = 0; i < virtualNodes; i++) {
            ring.put(hash(node + "#" + i), node);
        }
    }

    public void removeNode(String node) {
        // 从环上摘除所有虚拟节点
        for (int i = 0; i < virtualNodes; i++) {
            ring.remove(hash(node + "#" + i));
        }
    }

    public String getNode(String key) {
        if (ring.isEmpty()) return null;
        long h = hash(key);
        // 顺时针找到第一个虚拟节点
        Long nodeHash = ring.ceilingKey(h);
        // 没找到说明 key 的哈希值超过了环上最大的节点,绕回到第一个节点
        if (nodeHash == null) {
            nodeHash = ring.firstKey();
        }
        return ring.get(nodeHash);
    }

    // 计算哈希值,用 MD5 取前 8 字节
    private long hash(String key) {
        try {
            MessageDigest md = MessageDigest.getInstance("MD5");
            byte[] digest = md.digest(key.getBytes());
            long h = 0;
            for (int i = 0; i < 8; i++) {
                h = (h << 8) | (digest[i] & 0xFF);
            }
            return h;
        } catch (NoSuchAlgorithmException e) {
            throw new RuntimeException(e);
        }
    }


    // 统计每个节点分到的 key 数量
    private static Map<String, Integer> getDistribution(ConsistentHash ch, String[] keys) {
        Map<String, Integer> dist = new TreeMap<>();
        for (String key : keys) {
            String node = ch.getNode(key);
            dist.put(node, dist.getOrDefault(node, 0) + 1);
        }
        return dist;
    }

    // 获取每个 key 的映射关系,用于计算迁移量
    private static Map<String, String> getMapping(ConsistentHash ch, String[] keys) {
        Map<String, String> mapping = new HashMap<>();
        for (String key : keys) {
            mapping.put(key, ch.getNode(key));
        }
        return mapping;
    }

    // 统计迁移的 key 数量
    private static int countMigrations(Map<String, String> before, Map<String, String> after) {
        int count = 0;
        for (String key : before.keySet()) {
            if (!before.get(key).equals(after.get(key))) {
                count++;
            }
        }
        return count;
    }


    // 展示一致性哈希的分布和迁移量
    public static void main(String[] args) {
        String[] keys = new String[10000];
        for (int i = 0; i < keys.length; i++) {
            keys[i] = "key-" + i;
        }

        ConsistentHash ch = new ConsistentHash(200);

        // 初始状态:3 个节点
        ch.addNode("node-1");
        ch.addNode("node-2");
        ch.addNode("node-3");
        Map<String, String> mapping3 = getMapping(ch, keys);
        System.out.println("initial 3 nodes: " + getDistribution(ch, keys));

        // 扩容:添加第 4 个节点
        ch.addNode("node-4");
        Map<String, String> mapping4 = getMapping(ch, keys);
        int migrationsAfterAdd = countMigrations(mapping3, mapping4);
        System.out.println("after adding node-4: " + getDistribution(ch, keys));
        System.out.println("  migrated keys: " + migrationsAfterAdd + " (" + (migrationsAfterAdd * 100 / keys.length) + "%)");

        // 缩容:移除 node-2
        ch.removeNode("node-2");
        Map<String, String> mappingAfterRemove = getMapping(ch, keys);
        int migrationsAfterRemove = countMigrations(mapping4, mappingAfterRemove);
        System.out.println("after removing node-2: " + getDistribution(ch, keys));
        System.out.println("  migrated keys: " + migrationsAfterRemove + " (" + (migrationsAfterRemove * 100 / keys.length) + "%)");
    }
}
运行结果:
initial 3 nodes: {node-1=3453, node-2=3385, node-3=3162}
after adding node-4: {node-1=2599, node-2=2642, node-3=2456, node-4=2303}
  migrated keys: 2303 (23%)
after removing node-2: {node-1=3471, node-3=3435, node-4=3094}
  migrated keys: 2642 (26%)
可以看到:
-
分布均匀:无论是 3 个还是 4 个节点,每个节点分到的 key 数量都比较接近,这就是虚拟节点的作用。
-
迁移量小:扩容时只有约 23% 的 key 需要迁移,缩容时只有约 26% 的 key 需要迁移,十分接近理论值 25%。相比之下,取模法从 3 台扩容到 4 台需要迁移约 75% 的数据。
一致性哈希的核心就两点:哈希环确保节点变化时只影响相邻数据,虚拟节点确保负载均匀分布。理解了这两点,手写一致性哈希就不难了。