本站所有的例题、习题都选自 力扣/LeetCode 的公开免费题目,并给出题目的链接,你可以直接跳转到官网进行练习。
为了照顾初学者,下面快速介绍一下在线判题平台的判题机制以及使用技巧。
核心代码模式
在 力扣/LeetCode 上刷题,就是给你一个函数框架,你需要实现函数逻辑,这种模式一般称之为核心代码模式。
比如力扣第一题两数之和,就是让你实现这样一个 twoSum 函数:
class Solution {
    public int[] twoSum(int[] nums, int target) {

    }
}意思就是给你输入数组 nums 和目标值 target,你需要实现算法逻辑,最后计算返回一个数组。
你的解法代码提交到后台,它会给这个 twoSum 函数传入若干预定义的测试用例,对比你的返回值和正确答案,以此判断你的代码是否正确。
从用户角度来说,核心代码模式应该是最方便的形式,因为你只需要专心写好算法逻辑就行了。目前大部分刷题平台和技术面试/笔试场景都是核心代码模式。但是以防万一,这里还是要介绍一下 ACM 模式。
ACM 模式
ACM 模式就是更麻烦一些:题目给你输入的是特定格式的字符串,你需要自己解析这个字符串,然后把计算结果打印到标准输出。
你的代码提交到后台后,系统会把每个测试用例组织成特定格式的字符串传给你的程序,然后对比你程序的标准输出和预期输出是否相同,以此判断你的代码是否正确。
比如牛客网就提供这种 ACM 模式,我随便截个图你看看,代码编辑框没有任何初始代码,你需要从头自己写:
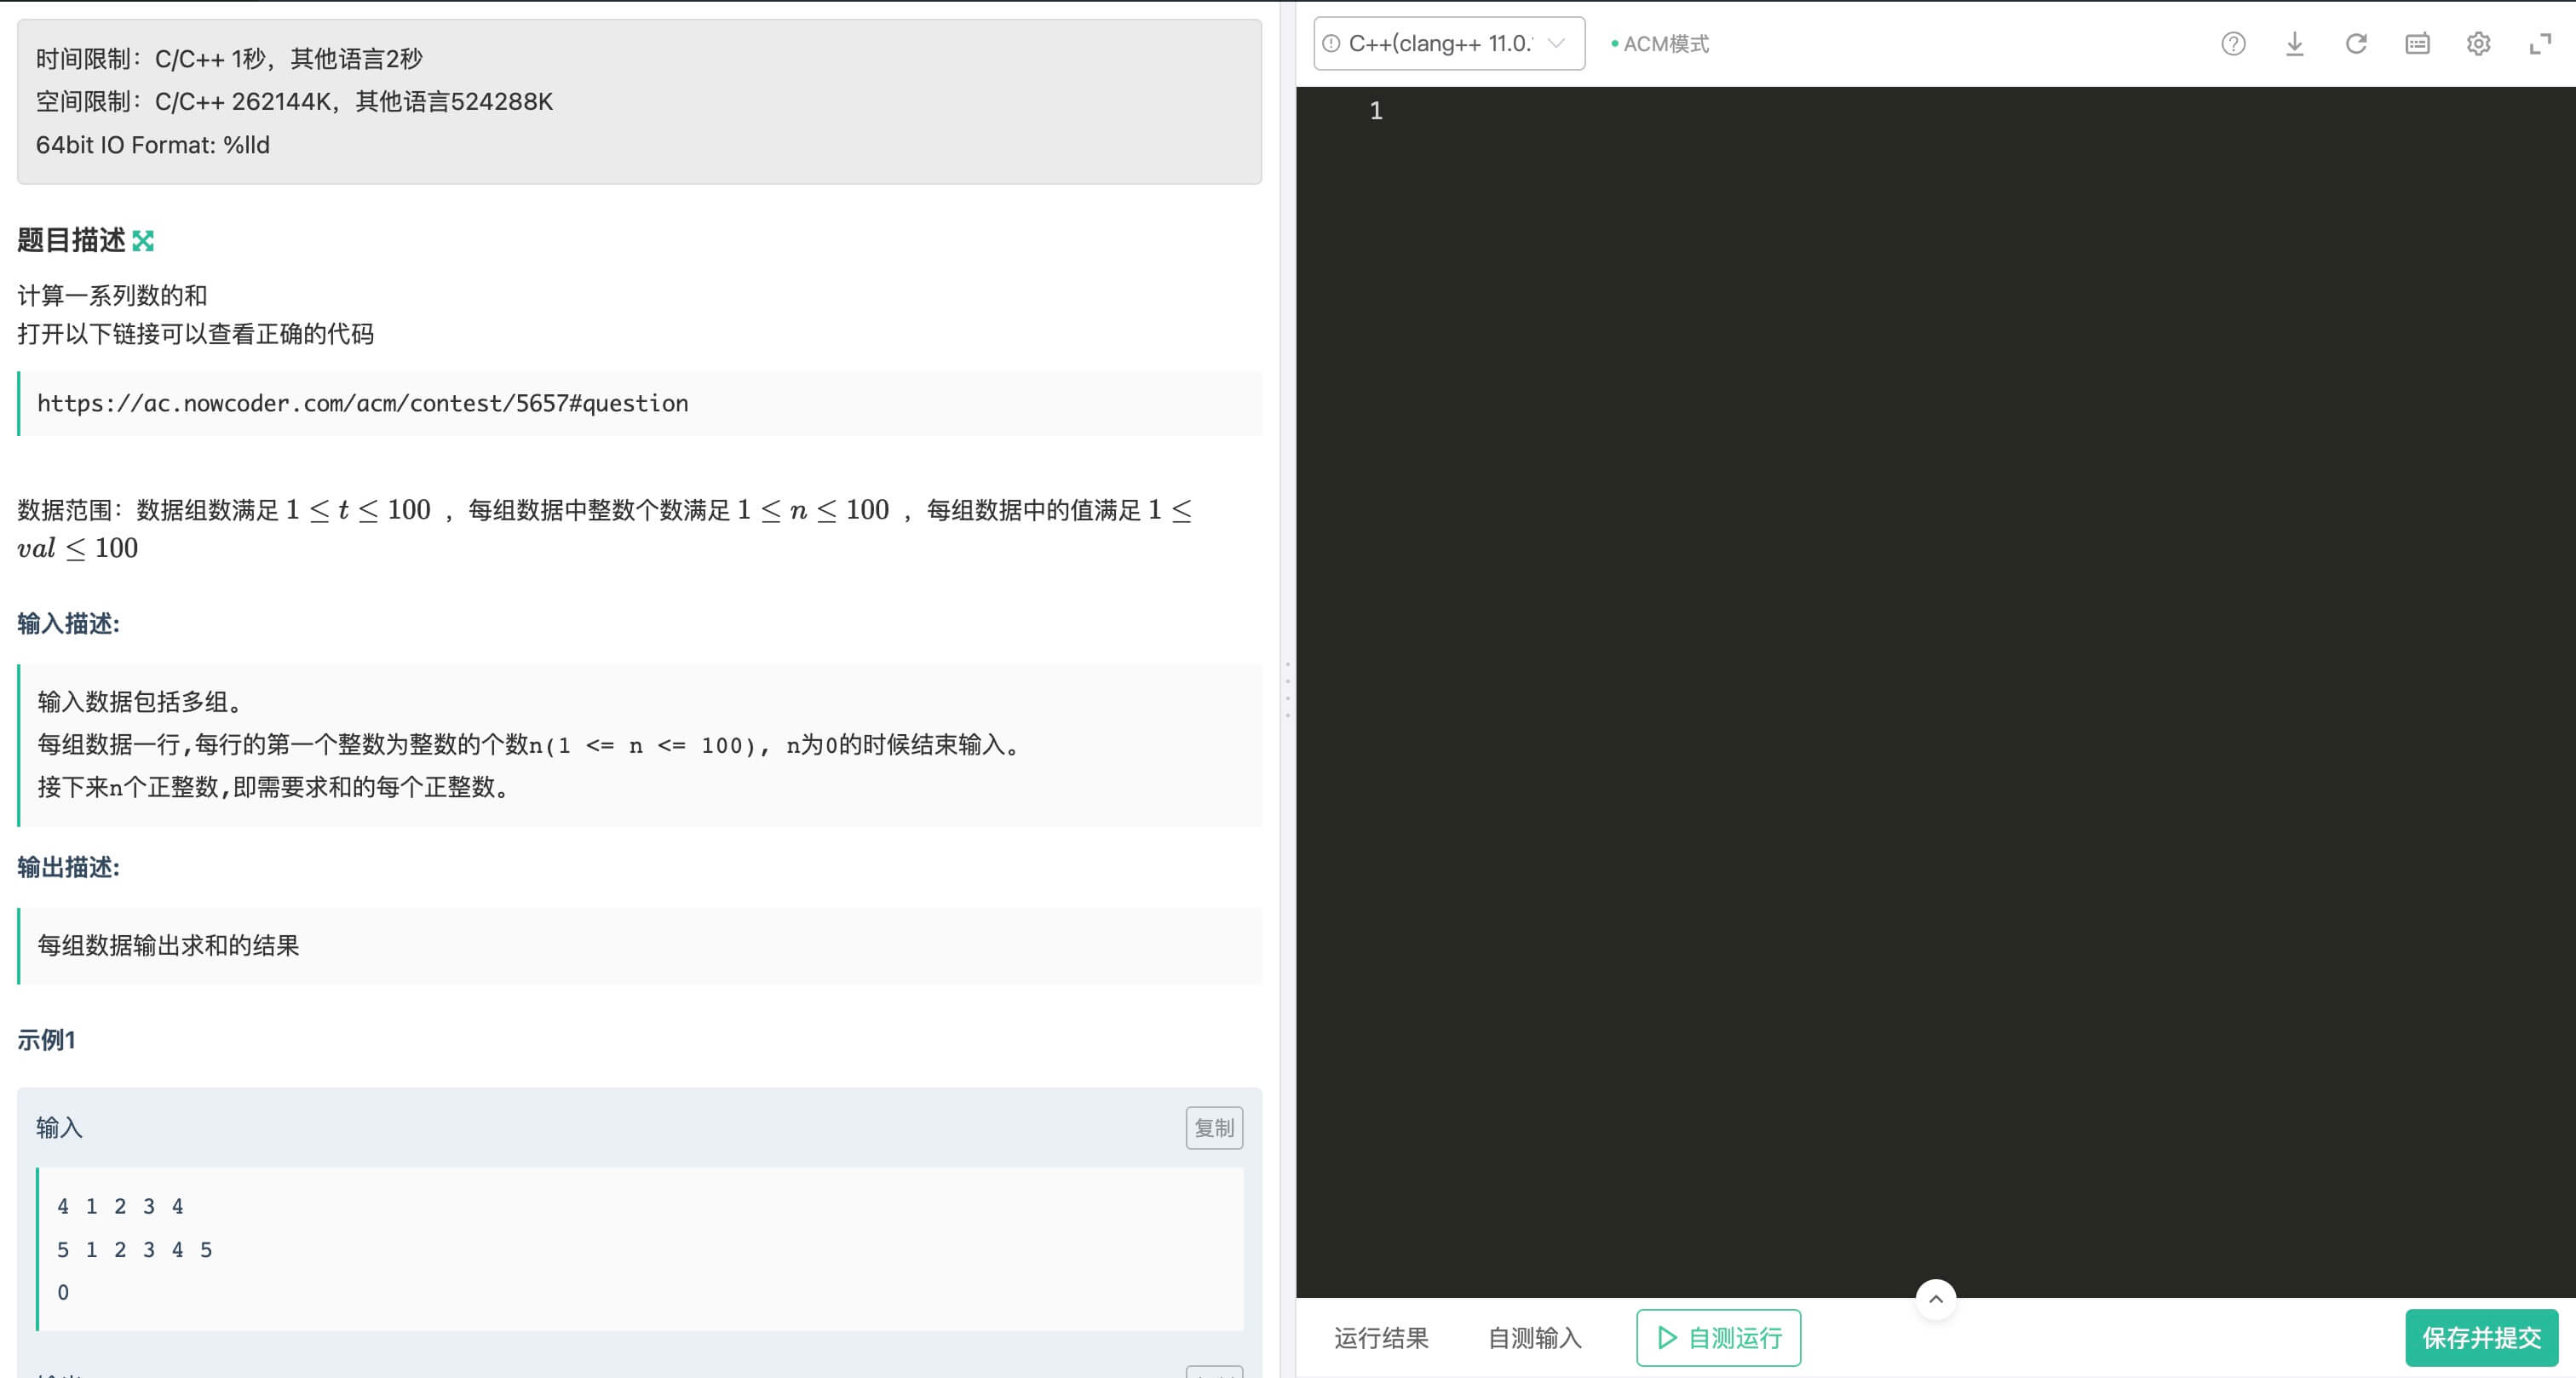
对于 ACM 模式,一个技巧就是要对代码分层,把对字符串输入的处理逻辑和真正的算法逻辑分开,类似这样:
public class Main {
    public static void main(String[] args) {
        Scanner scanner = new Scanner(System.in);
        // 这部分代码主要负责接收处理输入的数据,构建输入的用例
        int[] nums;
        int target;
        int N = scanner.nextInt();
        ...

        // 调用算法逻辑进行求解
        System.out.println(twoSum(nums, target));
    }

    public static int[] twoSum(int[] nums, int target) {
        // 转化为核心代码模式,在这里写算法逻辑
    }
}
这样看起来就很清晰,输入处理的逻辑可以作为模板直接复制粘贴,最终转化成核心代码模式,就和你在力扣上刷题就没什么区别了。
我的建议是,平时学习时,用核心代码形式就行了,简单方便。到了面试/笔试前夕,花上一两个小时就能熟悉 ACM 模式了。牛客网有专门练习这种 ACM 模式的例题,比如 这个题目列表。
下面介绍一下刷题平台的使用技巧,以及刷题平台是如何判断你的解法是否正确的。
如何读题
比如力扣第 704 题「二分查找」:
704. 二分查找 | 力扣 | LeetCode | 🟢
给定一个 n 个元素有序的(升序)整型数组 nums 和一个目标值 target ,写一个函数搜索 nums 中的 target,如果目标值存在返回下标,否则返回 -1。
示例 1:
输入:nums= [-1,0,3,5,9,12],target= 9 输出: 4 解释: 9 出现在nums中并且下标为 4
示例 2:
输入:nums= [-1,0,3,5,9,12],target= 2 输出: -1 解释: 2 不存在nums中因此返回 -1
提示:
- 你可以假设
nums中的所有元素是不重复的。 n将在[1, 10000]之间。nums的每个元素都将在[-9999, 9999]之间。
题目给你一个空的函数体,你需要实现这个 search 函数:
class Solution {
    public int search(int[] nums, int target) {
        // 你的代码写在这里
    }
}题目说给你输入一个升序排序的 nums 数组,让你在其中返回元素 target 的索引,如果找不到的话就返回 -1。
划重点,看清题目要求
看题要仔细,把题目给的所有信息都看清楚。很多读者只看题干和示例,却忽略了题目下方给出的数据规模等补充信息。
比如这道题,下面补充说明了 nums 的长度范围,和其中元素的大小范围,还有一个很重要的点,就是告诉你 nums 中并没有重复元素。
这是个关键信息,因为如果有多个相同的重复元素,那么你到底应该返回哪个索引呢?这些信息一般都会在补充说明中给出,一定要看清楚。
如何解题
这道题本意是想考察后面会讲的 二分搜索算法,不过这里先不管那么多,我们就这样写一个很直接的解法:
class Solution {
    public int search(int[] nums, int target) {
        // 遍历数组,找到目标元素就返回索引
        for (int i = 0; i < nums.length; i++) {
            if (nums[i] == target) {
                return i;
            }
        }
        return -1;
    }
}你把这段代码复制到力扣的编辑器里,点击「运行」按钮可以执行右下方的测试用例,点击「提交」按钮可以提交你的代码,看看是否通过了所有的测试用例。
如何调试
最理想的方式当然是直接在本地编辑器中刷力扣,方便打断点逐行调试。详细配置方法见网站配套的 vscode 插件 和 Jetbrains IDE 插件。
在网页刷题也有办法,可以直接在编辑器中写打印语句,力扣会把你的输出结果显示在右下方。对于比较简单的 bug,看一看输出也可以比较容易地找到问题。
提交时记得删除打印语句
因为打印语句输入 IO 操作,会影响代码的执行效率,所以提交前一定要记得删除,否则会导致算法的效率大幅下降。
判题机制
在我写这篇文章时,上述解法代码可以通过力扣的所有测试用例,可以成功提交。
力扣后台其实有很多预定好的测试用例,比如:
测试用例:nums = [-1,0,3,5,9,12], target = 9
预期输出:4

测试用例:nums = [-1,0,3,5,9,12], target = 2
预期输出:-1

测试用例:nums = [5], target = 5
预期输出:0

...
这些测试用例会作为参数传递给你实现的 search 函数,然后看你的函数返回值是否和预期输出一致。
如果一致,那么这个测试用例就通过了。如果所有的测试用例都通过了,那么就认为你的代码是正确的。
其实上面给出的解法代码并不是效率最优的解法,但是它确实能计算出正确的结果,而且没有超过判题平台规定的时间限制,所以判题平台认为它是正确的。
投机取巧
基于这个机制,其实判题平台并不会真的检查你的代码,你的代码好似一个黑盒,它只关心输入和输出是否符合预期。
那么如果题目有一些软限制,比方说禁止你使用 long 类型,禁止你使用标准库之类的约束,其实它只是那么说一说,没有办法真的禁止你使用。
如果笔试中遇到这种题目,你可以直接忽略这些限制,只要你的代码能够通过所有的测试用例,那么就是正确的。
当然,这属于投机取巧,在自己学习的过程中,还是要遵守题目的约束,否则面试的时候遇到类似的问题,你总不能当着面试官的面搞这些小动作吧。
提交代码可能出现的错误
如果提交的代码可以通过后台的所有测试用例,则称为提交成功,我们也常说 AC(Accepted)。
如果提交的代码不能通过所有测试用例,则称为提交失败,常见的失败原因有以下几种:
编译错误(Compile Error)
代码无法通过编译,这种错误一般是语法错误,比如拼写错误、缺少分号等。一般网页上手搓代码容易出现这种错误,使用本站配套 Jetbrains IDE 插件 或 vscode 插件 的话,编辑器会有基本的语法检查功能,一般不会出现这种错误。
运行错误(Runtime Error)
代码可以编译通过,但是在运行时出现了数组越界、空指针异常等错误。这种错误一般是由于边界条件处理不当,你需要留意边界条件、特殊测试用例(也叫做 Corner case,比如输入为空等情况)。
答案错误(Wrong Answer)
代码可以编译通过,也可以运行,但是某些测试用返回的结果和正确答案不一致。这种错误一般是因为你的算法有问题,需要你根据出错的用例反思,甚至可能整个思路都错了,需要你推倒重来。
超时(Time Limit Exceeded,常简称为 TLE)
力扣预定义的测试用例中,越靠后的用例数据规模就越大。如果你的算法的时间复杂度太高,在运行这些大规模的测试用例时就容易超过系统规定的时间限制,导致超时错误。
想要解决这个问题,你需要检查以下几点:
1、是否有冗余计算,是否有更高效的解法思路来降低时间复杂度。
2、是否有编码错误,比如边界控制出错导致死循环,错误地传值传引用导致无意义的数据拷贝等。
如果你卡在大规模的测试用例,一般就能说明你的算法结果是正确的,因为前面的小规模测试用例都通过了,只不过是时间复杂度太高,需要优化。
在笔试中,一般是按照通过的测试用例数量来计分的。所以如果你实在是想不出最优解法通过所有用例,提交一个暴力解,过几个用例捞点分,也是一种聪明的策略。
内存超限(Memory Limit Exceeded,常简称为 MLE)
和超时错误类似,内存超限一般是算法的空间复杂度太高,在运行大数据规模的测试用例时,占用的内存超过了系统规定的内存限制。
想要解决这个问题,你需要检查以下几点:
1、是否有申请了多余的空间,是否有更高效的解法思路来降低空间复杂度。
2、是否在递归函数中错误地使用了传值参数导致无意义的数据拷贝。
力扣提交代码的注意事项
对于初次使用力扣刷题的读者,我这里再介绍几个初学者容易踩的坑。
不要用文件级别的全局变量
前面说了力扣这种核心代码模式,会给你的算法代码输入若干预定义的测试用例,然后比较你的返回值和正确答案,那么就有很重要的一点:
你的代码不要用文件级别的全局变量,否则不同的测试用例之间可能会相互影响。力扣官网对于这个问题也有说明:https://support.leetcode.cn/hc/kb/article/1194344/
有些读者说他提交的解法通过不了,但是把出错的测试用例单独拎出来运行就是对的,一提交就错了,都是因为这个原因。你单独拎出来的时候只运行了一个测试用例,但提交后多个测试用例之间的数据产生了影响,就可能出错。
我在本站的教程中,尤其是讲解递归算法的部分,会经常提到「全局变量」这个词,但我指的全局变量并不是指文件级别的全局变量,而是类级别的全局变量。
具体举例说明吧,就比如二叉树的前序遍历这道题,题目输入一个二叉树的根节点,让你返回二叉树的前序遍历结果,你可以这样写:
class Solution {
    // 正确示例,类级别的全局变量
    LinkedList<Integer> res = new LinkedList<>();

    public List<Integer> preorderTraversal(TreeNode root) {
        traverse(root);
        return res;
    }

    void traverse(TreeNode root) {
        if (root == null) {
            return;
        }
        // 类内的其他函数都可以访问到 res
        res.add(root.val);
        traverse(root.left);
        traverse(root.right);
    }
}对于 Java/C++/Python 这种给了一个 Solution 类的情况,你就把需要共享访问的变量定义在类里面,对于 Go/JavaScript 这种没有类的情况,你可以定义高阶函数,运用闭包的特性,让内部函数也可以访问到共享变量。
或者,你可以把这个变量作为函数的参数传递,这样也是一种解决方案:
class Solution {
    public List<Integer> preorderTraversal(TreeNode root) {
        // 正确示例,作为参数传递给其他函数
        LinkedList<Integer> res = new LinkedList<>();
        traverse(root, res);
        return res;
    }

    void traverse(TreeNode root, LinkedList<Integer> res) {
        if (root == null) {
            return;
        }
        // 访问修改 res 变量
        res.add(root.val);
        traverse(root.left, res);
        traverse(root.right, res);
    }
}Important
对于这种方案,你要注意编程语言的特性,函数参数到底应该传值还是传引用/指针,否则会出现效率问题,甚至出错。
比方说上面的例子,C++ 代码中的 traverse 函数参数中一定要用传引用的方式 vector<int>& res,如果用传值的方式 vector<int> res,那么每次递归调用都会拷贝一个新的 vector<int> 对象,不仅会导致效率大幅下降,甚至可能导致答案错误。
提交时清除标准输出
在运行测试用例时,力扣会把你的算法的标准输出返回给你,也就是说你可以通过 print 打印一些数据来调试代码。这里注意,准备提交代码前一定要把所有的打印语句注释掉。
因为标准输出是 IO 操作,非常消耗时间。如果包含了打印语句,也许你的算法代码本身就是最优解,但提交后发现执行效率非常差,甚至因为超时而无法通过。
我就说这么多吧,接下来我会带你完成力扣上一些简单的题目作为实践,纸上得来终觉浅,绝知此事要躬行!