阅读本文前,建议先学习:
本文是 二分搜索核心框架 的补充,介绍另一种常见的二分搜索写法:左闭右开搜索区间。
第一篇推荐的两端都闭写法 [left, right] 更容易记忆,三种场景统一。但网上很多代码使用左闭右开写法 [left, right),本文帮你理解这种写法的逻辑,以免看到别人代码时看不懂。
两种写法没有优劣之分,你喜欢哪种就用哪种。只要你彻底理解了「搜索区间」的概念,两种写法都能随便写。
左闭右开的搜索区间
左闭右开写法的核心区别在于 right 的初始化:
// 「两端都闭」的写法
int right = nums.length - 1;  // right 是最后一个元素的索引

// 「左闭右开」的写法
int right = nums.length;      // right 是越界索引
把 right 初始化为 nums.length,因为索引 nums.length 是越界的,所以 right 这一边是开区间,搜索区间变成了 [left, right)。
相应地,while 的终止条件也要改变。
两端都闭 [left, right] 的写法中,while(left <= right) 循环终止时 left == right + 1,区间 [right+1, right] 为空,正确。
左闭右开 [left, right) 的写法中,为了确保算法终止时搜索区间为空,应该使用 while(left < right),这样循环结束时 left == right,区间 [left, left) 为空区间。
左闭右开搜索区间的边界更新也有变化。
两端都闭的写法中,mid 索引已经搜索过,应该从搜索区间中去除,下次搜索区间为 [left, mid-1] 或 [mid+1, right]。
左闭右开的写法中,mid 索引已经搜索过,应该从搜索区间中去除,下次搜索区间为 [left, mid) 或 [mid+1, right)。
明白上述变化,就足够写出正确的二分搜索代码了。下面分别探讨寻找一个数、寻找左侧边界、寻找右侧边界三种场景。
寻找一个数
按照前面关于左闭右开搜索区间的讲解,应该可以直接写出寻找目标值的索引的代码了。
在 nums 中寻找目标值 target,如果存在返回其索引,否则返回 -1:
int binary_search(int[] nums, int target) {
    // right 初始化为 nums.length
    // 左闭右开的搜索区间
    int left = 0, right = nums.length;

    // 用 < 而不是 <=,因为 left == right 时搜索区间为空
    while (left < right) {
        int mid = left + (right - left) / 2;
        if (nums[mid] == target) {
            return mid;
        } else if (nums[mid] < target) {
            // 下一轮搜索区间为 [mid+1, right)
            left = mid + 1;
        } else if (nums[mid] > target) {
            // 下一轮搜索区间为 [left, mid)
            right = mid;
        }
    }
    return -1;
}寻找左侧边界
下面是左闭右开写法的搜索左边界代码:
// 搜索左侧边界
int left_bound(int[] nums, int target) {
    if (nums.length == 0) return -1;
    int left = 0, right = nums.length;

    while (left < right) {
        int mid = left + (right - left) / 2;
        if (nums[mid] == target) {
            // 当找到 target 时,收缩右侧边界
            right = mid;
        } else if (nums[mid] < target) {
            left = mid + 1;
        } else if (nums[mid] > target) {
            right = mid;
        }
    }
    return left;
}
while 循环的结束条件、left, right 的更新方式同上,不做赘述。下面解释几个不同点。
为什么这个算法可以搜索左侧边界?
关键在于对 nums[mid] == target 的处理:
if (nums[mid] == target) {
    // 收缩右边界
    right = mid;
}
每次找到 target 时,不立即返回,而是缩小右边界,在区间 [left, mid) 中继续搜索,即不断向左收缩,达到锁定左侧边界的目的。
target 不存在时返回什么?
如果 target 不存在,left_bound 返回的索引是「大于 target 的最小索引」。
这个结论不用死记,举个例子就能得出,比如 nums = [2,3,5,7], target = 4,返回值是 2,因为元素 5 是大于 4 的最小元素。
如果想让 target 不存在时返回 -1,在返回的时候额外判断一下 nums[left] 是否等于 target 就行了:
// 如果越界,target 肯定不存在,返回 -1
if (left < 0 || left >= nums.length) {
    return -1;
}
// 判断一下 nums[left] 是不是 target
if (nums[left] != target) {
    return -1;
}
// nums[left] == target,目标索引为 left
return left;寻找右侧边界
左闭右开的右边界搜索写法:
// 搜索右侧边界
int right_bound(int[] nums, int target) {
    if (nums.length == 0) return -1;
    int left = 0, right = nums.length;

    while (left < right) {
        int mid = left + (right - left) / 2;
        if (nums[mid] == target) {
            // 当找到 target 时,收缩左侧边界
            left = mid + 1;
        } else if (nums[mid] < target) {
            left = mid + 1;
        } else if (nums[mid] > target) {
            right = mid;
        }
    }
    return left - 1;
}为什么该算法能够搜索右侧边界?
关键在于对 nums[mid] == target 的处理:
if (nums[mid] == target) {
    // 收缩左边界
    left = mid + 1;
}
找到 target 时不要立即返回,而是收缩左边界 left = mid + 1,在区间 [mid+1, right) 中继续搜索,即不断向右收缩,达到锁定右侧边界的目的。
为什么返回 left - 1?
因为我们对 left 的更新必须是 left = mid + 1,就是说 while 循环结束时,nums[left] 一定不等于 target 了,而 nums[left-1] 可能是 target。
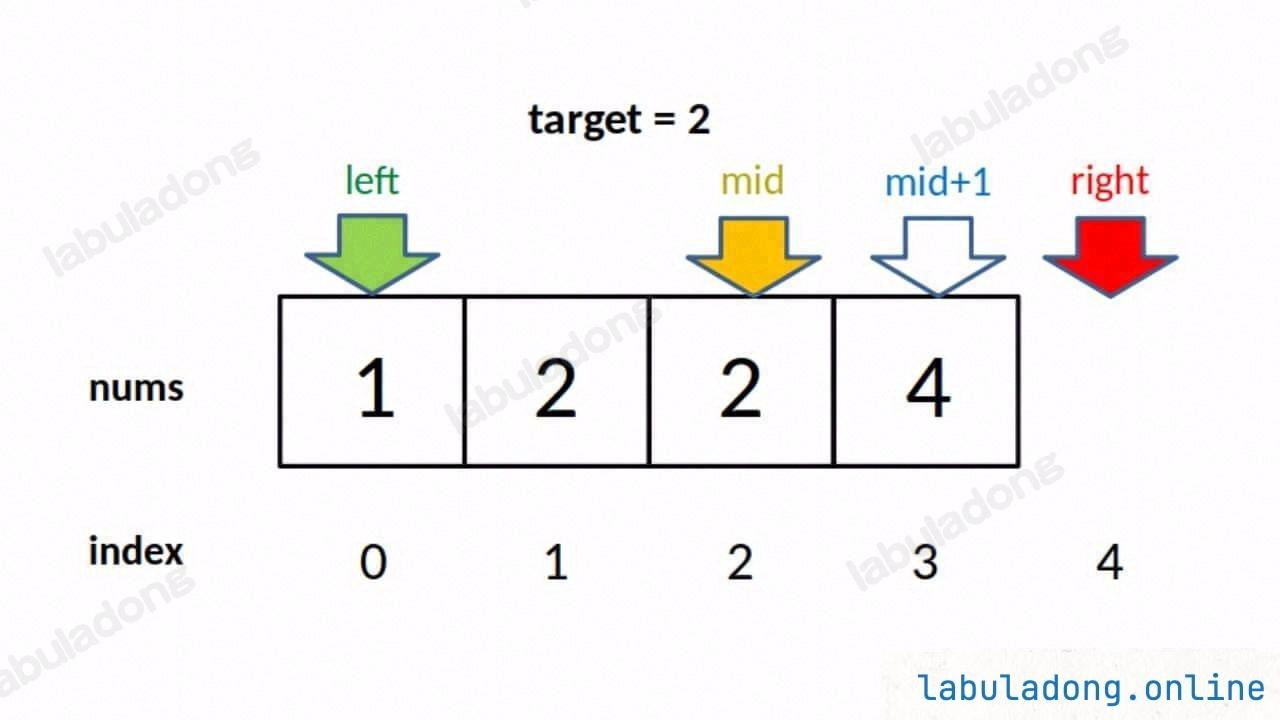
由于 while 的终止条件是 left == right,所以返回 left - 1 或 right - 1 都可以。
target 不存在时返回什么?
和 left_bound 相反:如果 target 不存在,right_bound 返回的索引是「小于 target 的最大索引」。
比如 nums = [2,3,5,7], target = 4,返回值是 1,因为元素 3 是小于 4 的最大元素。
如果想让 target 不存在时返回 -1:
if (left - 1 < 0 || left - 1 >= nums.length) {
    return -1;
}
if (nums[left - 1] != target) {
    return -1;
}
return left - 1;两种写法对比
两端都闭 [left, right] | 左闭右开 [left, right) | |
|---|---|---|
right 初始化 | nums.length - 1 | nums.length |
| while 条件 | left <= right | left < right |
| 终止时 | left == right + 1 | left == right |
| 收缩右边界 | right = mid - 1 | right = mid |
| 收缩左边界 | left = mid + 1 | left = mid + 1 |
只要你理解了「搜索区间」这个概念,就能有效避免漏掉元素,两种写法都能正确工作。
我个人比较推荐使用前文讲的 两端都闭的写法,因为三种场景可以统一框架,只需修改 nums[mid] == target 条件处的代码即可。